本地跑开源模型:显存估算、量化档位与隐私边界怎么核对
摘要:本站 Ollama 入门文讲过安装与粗算表。本文换核对线:用 Hugging Face Accelerate 的 estimate-memory 估权重占用;对照 fp16 / int8 / int4(bitsandbytes)与常见 GGUF 量化档;再分清「权重在本机」和「对话内容真不出网」的隐私边界。只放官网普通链接。
本站 用 Ollama 在自己电脑上跑大模型 讲过安装、按机器挑大概尺寸、本地 API。那篇够你先跑起来。本文只核对三件事: 显存怎么估(别只看参数量口号)、量化档位差在哪、以及本地部署时隐私边界画到哪。不评哪家模型「最强」,不写行情式排行。
查询日期:2026-10-30(北京时间)。文档会改版,以官网当前页为准。正文只放官网/文档普通链接(affiliate_later)。
1. 先分清:权重显存 ≠ 推理时真实占用
很多人卡在「7B 到底要不要 24G 卡」。粗口径可以记:
| 你看到的数字 | 大致指什么 | 容易漏掉的 |
|---|---|---|
| 参数量(如 8B) | 权重个数量级 | 不含 KV cache、激活、框架开销 |
| 量化后文件大小 | 磁盘上权重体积 | 加载后仍可能再占上下文缓存 |
nvidia-smi 峰值 | 某次真实推理 | 和 batch、上下文长度强相关 |
Hugging Face Accelerate 文档提供 CLI:accelerate estimate-memory <模型名>。它在 meta 设备上读配置估占用,不必把完整权重下到本机,适合先筛「这台机器装不装得下权重」。
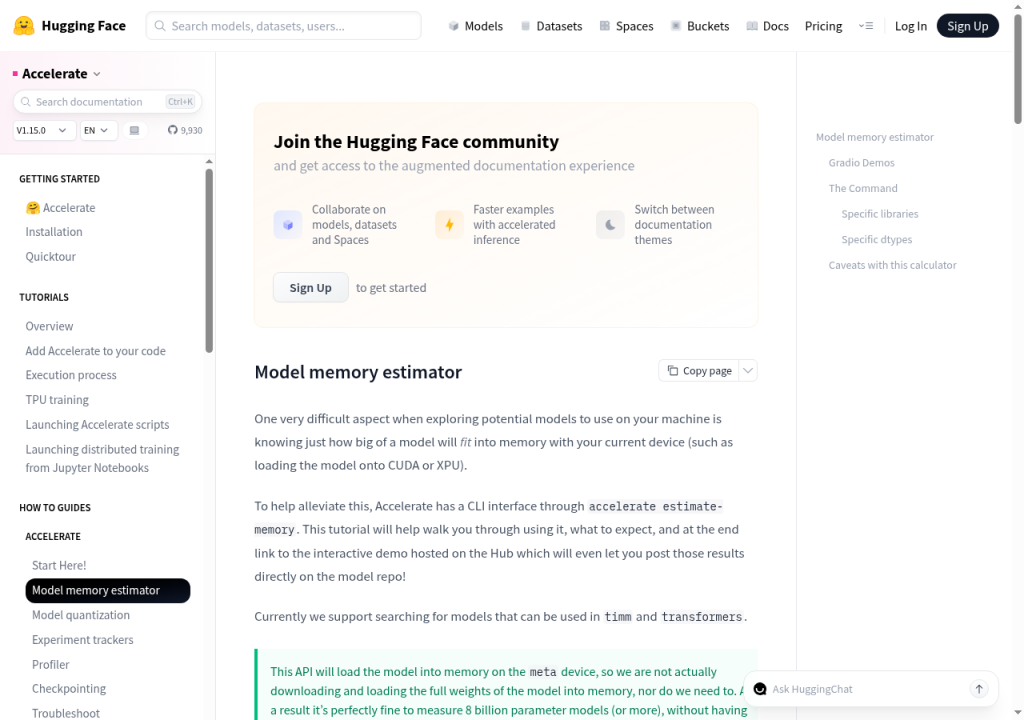
文档示例(以当前页表格为准):对 bert-base-cased 会分别给出 float32 / float16 / int8 / int4 的 Total Size,以及若用 Adam 训练时的更大占用。重要 caveat(文档原文口径): 该计算器估的是加载权重所需内存,不是完整推理;推理时往往还要再留余量(文档提到可参考约额外 20% 量级的经验说法,仍以你实测为准)。
命令形态示例(模型名换成你要估的仓库 id):
accelerate estimate-memory bert-base-cased
# 库名识别不准时:
accelerate estimate-memory <org/model> --library_name transformers
估完权重后,再用一次短上下文试跑,看 nvidia-smi / Activity Monitor,再决定要不要加长上下文。
2. 量化档位:fp16、int8、int4 差在哪
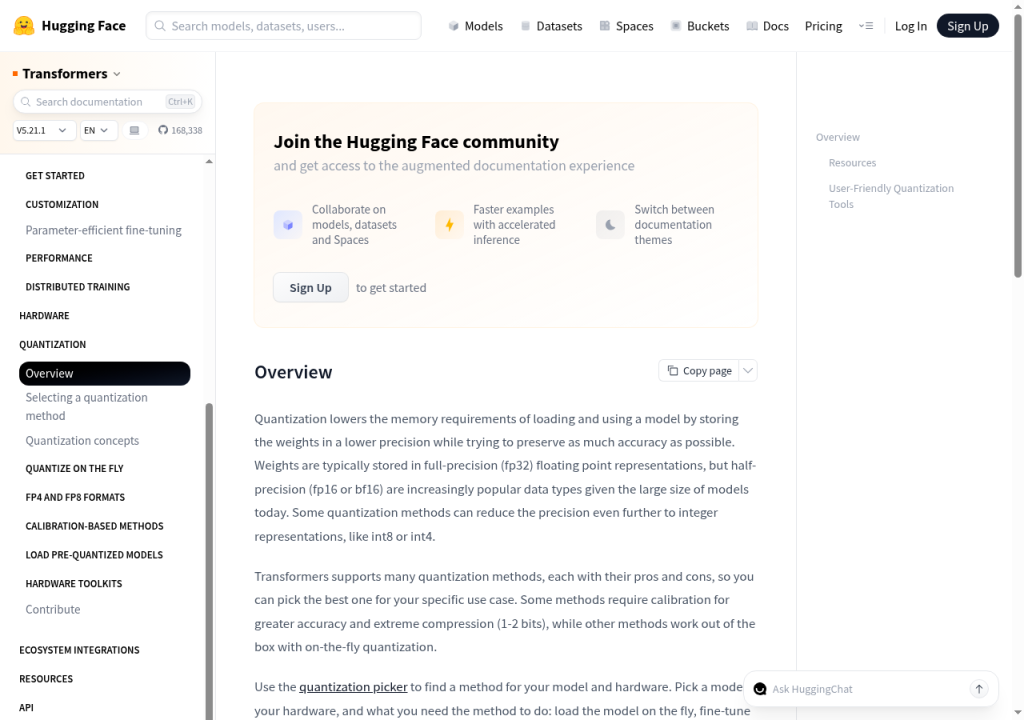
Transformers 文档把 bitsandbytes 描述成「有限算力下缩小内存占用」的量化工具:用 Linear8bitLt / Linear4bit 等替换标准线性层;并可用 get_memory_footprint() 查看占用。
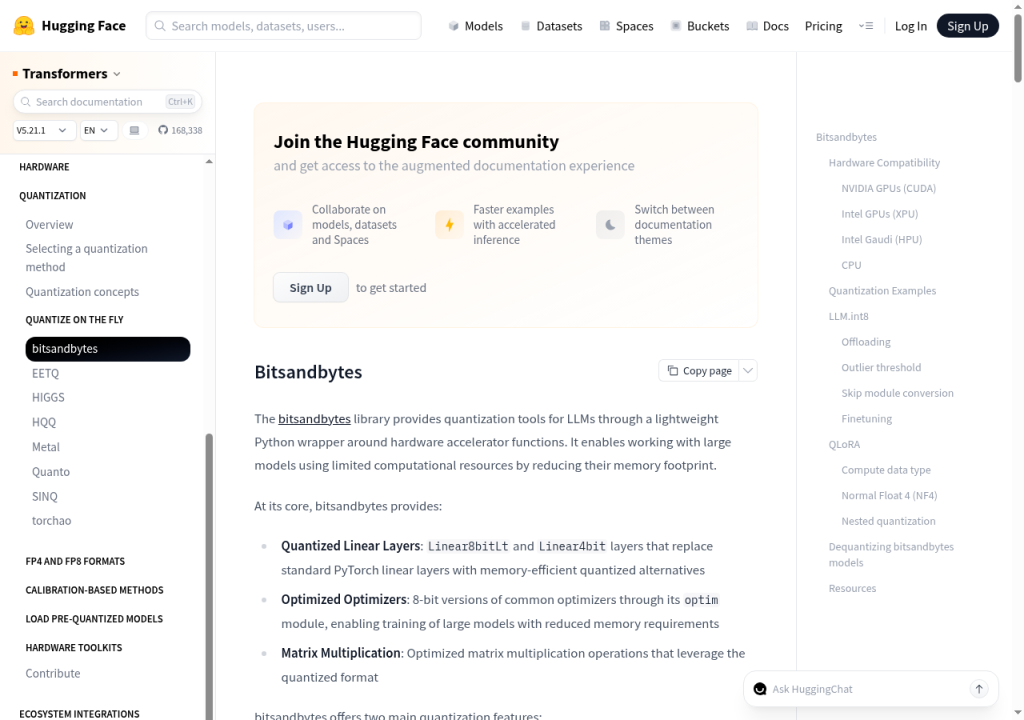
公开文档里的常用对照(相对 bf16/fp16 权重量级,任务效果以你自己的样例集为准):
| 档位 | 权重内存大致变化(文档口径) | 常见用途 | 核对时盯什么 |
|---|---|---|---|
| fp16 / bf16 | 基线 | 效果对照、显存够时 | 峰值是否已接近卡容量 |
| int8(如 bnb 8-bit) | 约减半 | 显存紧张但仍要接近基线质量 | CUDA 环境、device_map |
| int4 / NF4(如 bnb 4-bit) | 约降至约 1/4 | 消费级卡上跑更大模型、QLoRA 微调 | 校准与否、任务准确率掉多少 |
| GGUF Q4_K 等(llama.cpp / Ollama 路线) | 按具体 quant 文件 | 桌面一键跑、CPU/GPU 混用 | 文件名档位、上下文长度 |
选型时建议按这个顺序,而不是先追「最低 bit」:
- 用
estimate-memory看 fp16 / int8 / int4 权重档是否落在你的显存预算内(再留 KV 余量)。 - 同一提示词集上对比:事实问答、代码补全、长文摘要各抽几条,看是否可接受。
- 若走 Ollama / GGUF:在 Ollama 模型库 看具体 tag 的体积,再对照本机可用内存;安装入口见官网 ollama.com/download。
- 微调场景另查 PEFT / QLoRA 文档;推理-only 别把训练占用表当成上线预算。
语音侧本地模型的 VRAM 档位表,可参考本站 本地 Whisper 与在线 STT 隐私取舍 里的官方 model 表截图思路:先小档试通,再升档。
3. 隐私边界:权重在本地,不等于对话不出网
「本地开源模型」常被说成绝对隐私。实操里要拆开核对:
| 环节 | 更稳妥的默认 | 常见漏点 |
|---|---|---|
| 权重文件 | 已下载到本机磁盘/本机 GPU | 一键「网页壳」仍可能把请求打到云端 |
| 对话与系统提示 | 默认应只进本机进程 | 插件、同步盘、崩溃上报、远程「增强检索」 |
| 文档 RAG | 向量库是否本机 | 嵌入 API 若走云,原文切片已出网 |
| 日志 | 关闭无关遥测 | 终端历史、IDE 云同步里的密钥 |
通用「哪些别贴进公有对话框」见 AI 工具的数据隐私。本地笔记接 AI 时,引用与切片边界见 个人知识库接 AI。
核对清单(可勾):
- □ 推理进程是本机
ollama/llama.cpp/ 自建 Transformers,还是带云推理的壳 - □ 关闭或确认:遥测、自动更新上报、IDE「云补全」是否同时开着
- □ RAG 用的 embedding 是本地模型还是云 API
- □ 提示词与日志目录是否进了网盘/公开仓库
- □ 客户合同若要求「数据不出境」,是否需要书面架构说明,而不只是「我用了开源模型」一句话
幻觉与引用核对仍要做人审,见 大模型幻觉怎么防。
4. 一条可执行的落地顺序
- 定场景:只聊天、要写代码、还是要跑私有文档问答。
accelerate estimate-memory(或厂商卡密表)筛权重档。- 选量化:先 int8/Q5 一类偏稳的,再视显存降到 int4/Q4。
- 固定 10~20 条自家样例做验收,不通过就升档或换模型,不先加长上下文硬撑。
- 再画隐私边界:本机进程、本机向量库、禁用不必要的云插件。
- 提示词与模板复用见 提示词四段框架;需要一键体验时回到 Ollama 入门。
相关阅读
- 用 Ollama 在自己电脑上跑大模型
- AI 工具的数据隐私:哪些不要粘贴
- 本地 Whisper 与在线 STT 隐私取舍
- 个人知识库问答入门:AnythingLLM、Dify
- 大模型幻觉怎么防
- 提示词怎么写:四段框架
来源: Hugging Face Accelerate · Model memory estimator、Transformers · bitsandbytes、Transformers · Quantization overview、Ollama Download。查询日期 2026-10-30。