摘要:本地笔记接上大模型后,最容易翻车的不是「能不能答」,而是答出来却对不上出处。本文按 Ollama 嵌入说明、LlamaIndex 查询三阶段、Chroma 检索能力与 Anthropic Citations 文档,整理「切片→嵌入→检索→引用核对」清单;并对照《生成式人工智能服务管理暂行办法》划清个人自用与对外服务边界。查询日期 2026-10-20;无联盟链接。
依据:Ollama 《Embedding models》、LlamaIndex — Querying / Stages of querying、Chroma Docs — Introduction、Anthropic — Citations、中国政府网《生成式人工智能服务管理暂行办法》。查询日期:2026-10-20(北京时间)。只放官网/权威普通链接(
affiliate_later)。不构成法律或合规意见;以你所在场景与最新规则为准。
本站已有 Obsidian + AI 插件搭建个人知识库(笔记软件与插件安全)和 AnythingLLM / Dify 本地部署与文档切片(部署与切片参数)。本文不重复装哪一套面板,只收窄到一件事:把本地笔记做成可检索向量之后,回答里的引用怎么核对,避免「答得像、出处对不上」。
一、先把链路画清楚:不是「把库文件整份贴进对话框」
| 步骤 | 做什么 | 常见翻车点 |
|---|---|---|
| 1. 整理源文件 | Markdown / PDF / 导出笔记,统一编码与文件名 | 同一主题多份旧稿,检索命中过期版本 |
| 2. 切片(chunk) | 按标题/段落切成可检索小段,并保留来源路径、标题、日期等元数据 | 切太碎丢上下文;切太大一次塞进模型后「哪句出自哪段」对不上 |
| 3. 嵌入(embedding) | 用嵌入模型把每段变成向量 | 换嵌入模型却不重建索引;中英混排未测召回 |
| 4. 入库检索 | 向量库按相似度取 top-k,可再加关键词/元数据过滤 | 只看向量、不过滤「草稿/已废止」标签 |
| 5. 生成 + 引用 | 模型只基于检索到的片段组织答案,并标回来源 | 模型编造页码/文件名;或根本没打开引用字段就当「有出处」 |
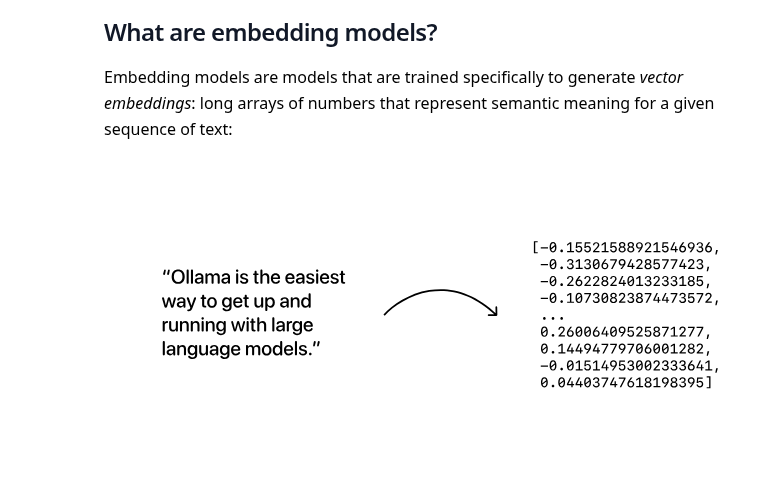
Ollama 官方对嵌入模型的说明很直白:嵌入模型专门生成向量(一长串数字),用来表示一段文本的语义,从而把提示词与已有文档拼成检索增强(RAG)应用。
本地推理可配合 Ollama 本机跑大模型;若推理走云端 API,至少应清楚:提问文本与检索出的片段可能出域,敏感笔记优先本机嵌入 + 本机推理。别往对话框贴的内容见 AI 隐私:哪些别贴。
二、向量库选什么:看「能不能带着元数据找回原文」
开源向量库很多,选型时优先问三句:
- 能否同时存原文片段 + 元数据(路径、标题、标签、日期)?
- 除了稠密向量,是否支持关键词 / 过滤(避免「语义像但文件错」)?
- 换嵌入模型后,是否有重建索引的明确流程?
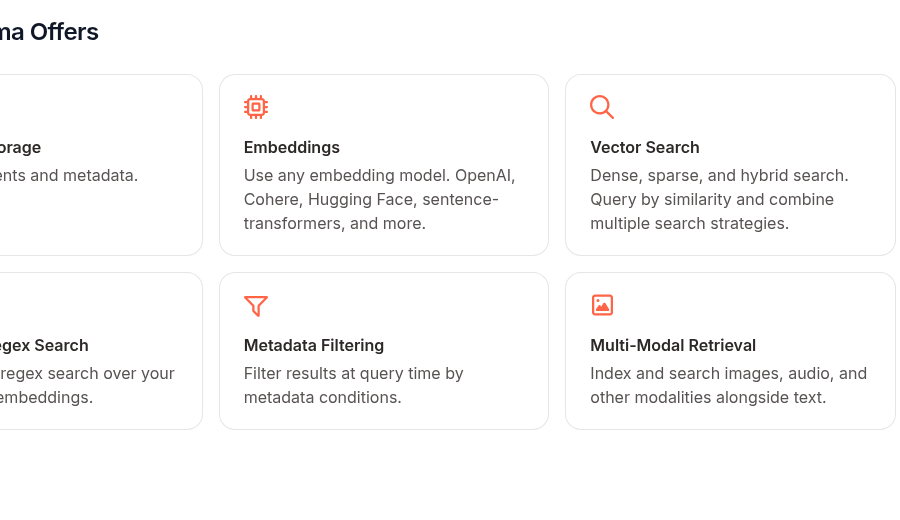
Chroma 官方介绍把自己定位为面向 AI 的开源数据基础设施,能力卡片里直接列出:文档与元数据存储、任意嵌入模型、稠密/稀疏/混合检索、元数据过滤、多模态检索等——对个人知识库来说,「搜得到 + 能按标签过滤」比「换成某家更火的库」更重要。
AnythingLLM、Dify 一类产品多半在背后接了类似能力;你若已经按本地 RAG 切片文跑通部署,下一步应把精力放在元数据约定与引用核对,而不是再换一套面板。
三、查询不是一步:检索 → 后处理 → 再合成回答
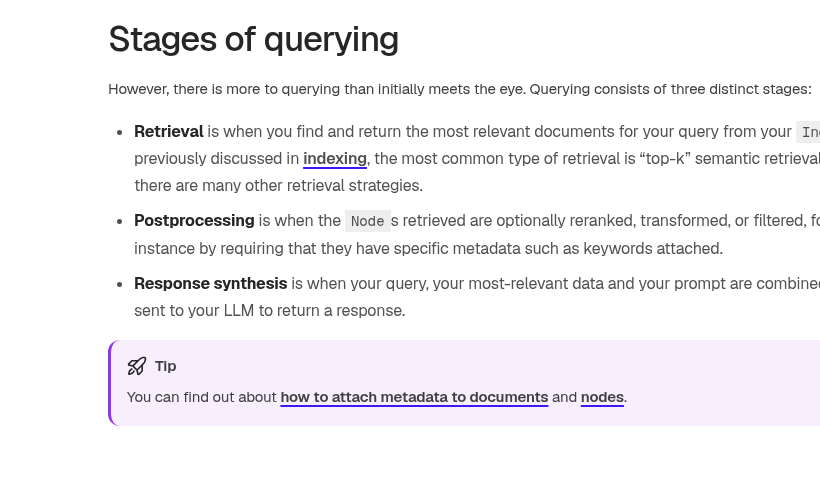
LlamaIndex 文档把 querying 拆成三个阶段(公开表述):
- Retrieval:从索引里找出与问题最相关的文档/节点(常见 top-k 语义检索);
- Postprocessing:对命中节点重排、变换或过滤(例如按关键词元数据丢掉无关段);
- Response synthesis:把问题、检索结果与提示词一起交给大模型生成回答。
个人实践里对应成可检查的习惯:
- 提示词写明:只依据提供的片段作答;片段不足就说「库里没有」,不要补全「听起来合理」的细节(框架写法见 提示词四段框架);
- 打开 top-k 日志:每次回答至少能回看「命中了哪几个文件/标题」;
- 对制度、合同、报价、日期类问题,生成后再走一遍幻觉核查清单。
四、引用核对:有「引用字段」也不等于已经核实
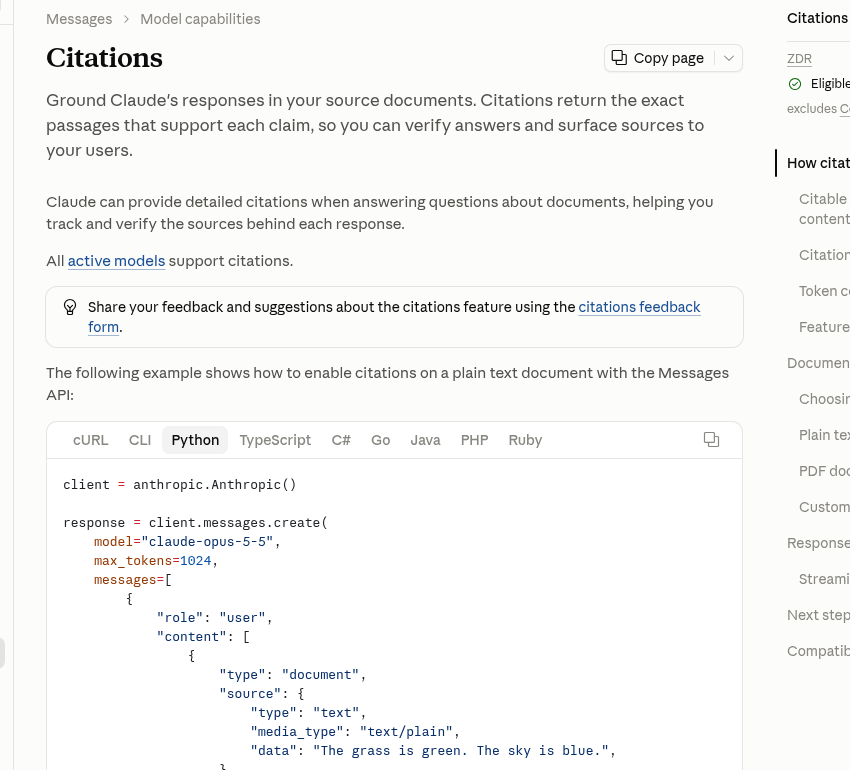
部分模型/API 提供 Citations(引用) 能力:要求模型把答案锚定到你提供的源文档,并返回可核对的原文片段。Anthropic 文档写明:citations 用于让回答 grounded in source documents,并返回 exact passages 以便核查;当前活跃模型均支持该能力(以文档当日说明为准)。
落地时建议固定一张人工勾选表(外发/写进周报/写进客服知识库前):
- □ 每个关键数字/专有名词,能在命中片段里逐字找到(不是「意思接近」)
- □ 引用的文件名/标题与磁盘上的源文件一致,不是模型顺口编的
- □ 命中的是现行版本(看元数据日期;旧版已标
deprecated) - □ 没有把「检索摘要」误写成「原文条款」
- □ 若 API 返回了 citation 字段,抽 2 条点开对照;字段为空则当无引用处理
- □ 涉及他人隐私、未公开商业数据:确认片段本就不该进库,或已脱敏
竞品调研场景的「信息源标注」可对照本站 竞品调研表防幻觉清单;本文更偏个人笔记库。
五、合规边界:个人自用 vs 向境内公众提供服务
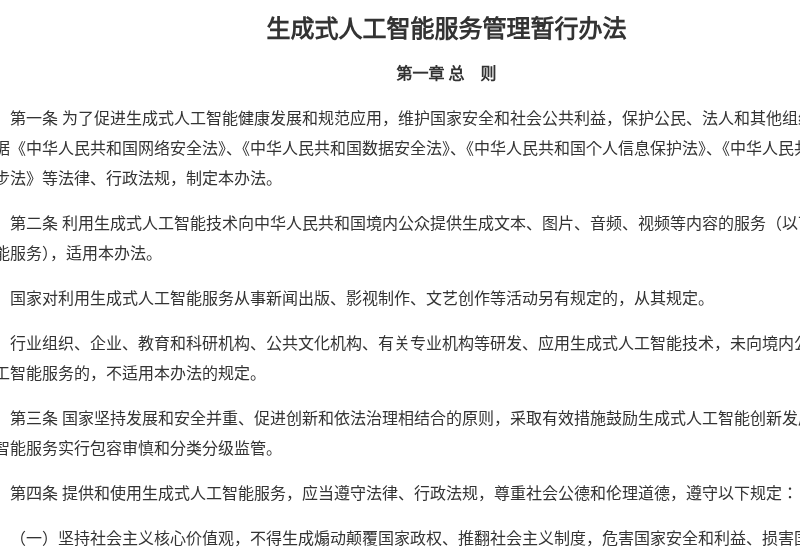
《生成式人工智能服务管理暂行办法》第二条写明:利用生成式人工智能技术向中华人民共和国境内公众提供生成文本、图片、音频、视频等内容的服务,适用本办法;行业组织、企业、教育和科研机构等研发、应用生成式人工智能技术,未向境内公众提供生成式人工智能服务的,不适用本办法。
一句话对照:
| 你的做法 | 通常怎么理解(以原文与主管口径为准) |
|---|---|
| 本机笔记库 + 自用问答,不对公众开放 | 更接近「未向境内公众提供服务」的研发/自用场景,但仍须守数据安全、个人信息保护等一般法律 |
| 把同一套知识库做成网站/小程序,谁都能问 | 可能落入「向境内公众提供服务」,需另行评估备案、标识、内容安全等义务 |
| 用云端 API 处理客户合同原文 | 先看数据处理协议与是否获授权,别默认「模型商不会存」 |
标识与对外展示另见 AI 内容标识办法对自媒体。
六、最小可行流程(可今天就做)
- 挑一个主题文件夹(例如「社保报销」「服务器排错」),先删掉明显过期的副本。
- 约定元数据:
source_path / title / updated / status(active|deprecated)。 - 选一个嵌入模型并固定版本;换模型就重建索引。
- 提问时强制输出:
结论+依据片段原文摘录+来源路径;缺依据就回答「库中未找到」。 - 每周抽 5 个问题做引用抽检,失败的回写切片规则(切太大/太碎/缺标题)。
七、相关阅读
- Obsidian 笔记 + AI 插件搭建个人知识库
- 个人知识库问答入门:AnythingLLM、Dify 本地部署与文档切片
- 大模型幻觉怎么防:6 类高风险场景和一张核查清单
- 提示词怎么写:角色、任务、约束、格式四段框架
- AI 工具的数据隐私:哪些内容别往对话框里贴
- 用 Ollama 在自己电脑上跑大模型
- 用 AI 做竞品调研表:信息源标注、引用核对与防幻觉清单
来源与查询日期
- Ollama — Embedding models
- LlamaIndex — Querying
- Chroma Docs — Introduction
- Anthropic — Citations
- 中国政府网 — 生成式人工智能服务管理暂行办法
- 查询日期:2026-10-20(北京时间)。文档与法规可能更新,请以原文为准。
风险提示:向量检索与大模型都可能漏检、错检或生成不准确内容;涉及财务、法律、医疗、合规结论须人工核对源文件。本文不构成技术选型担保或法律意见。本地部署仍须做好备份、访问控制与依赖升级。