AI 语音转写工具怎么选:本地 Whisper 与在线服务的隐私取舍(2026)
摘要:会议录音、访谈与播客转写,先分清「音频会不会离开本机」。本文按 OpenAI Whisper 开源仓库与 model card、平台 Speech-to-Text / 数据控制文档,对照本地 Whisper 与云端 STT 的隐私、硬件与准确度取舍;不绑定某一家会议 App。
依据:OpenAI Whisper GitHub、Whisper model card、OpenAI《File transcription / Speech to text》、OpenAI《Data controls in the OpenAI platform》、Whisper 简介(OpenAI)。查询日期:2026-10-17(北京时间)。工具可替换;只放官网/文档普通链接(
affiliate_later)。
本站已有AI 整理会议录音:转写、摘要与待办(偏会后工作流:转写→纪要→待办)和用 AI 写短视频脚本和字幕(偏口播与字幕校对)。本文换一条线:本地 Whisper vs 在线转写服务的隐私取舍——先决定音频离开不离开本机,再谈模型大小与准确度。
一、先问一句:这段音频能不能上传?
| 音频内容 | 更稳妥的默认 |
|---|---|
| 含身份证号、银行卡、未公开并购、薪酬、客户密钥、未授权肖像访谈 | 本地转写,或脱敏后再上传 |
| 公开播客、已获授权的对外采访、无敏感字段的内部周会 | 本地或云端均可,仍建议去标识 |
| 不确定有没有敏感字段 | 先本地,或先人工听一遍再决定 |
「哪些东西不要贴进公有模型」的通用边界,见AI 工具的数据隐私。转写只是第一步:摘要与待办仍要人工核对,见大模型幻觉怎么防。
二、本地 Whisper:开源模型,音频可以留在本机
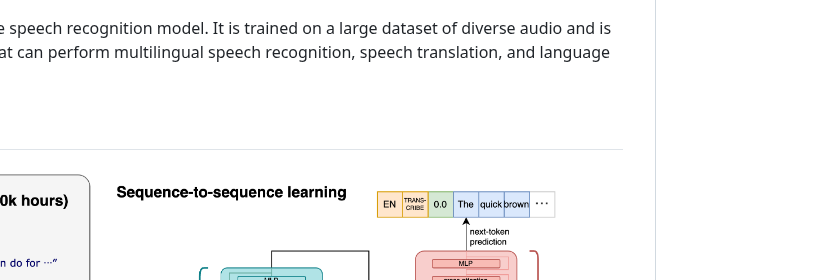
OpenAI 将 Whisper 描述为通用语音识别模型,在大规模弱监督数据上训练,可做多语言识别、语音翻译与语种识别;代码与权重以开源形式发布,便于在本机或自有服务器推理。
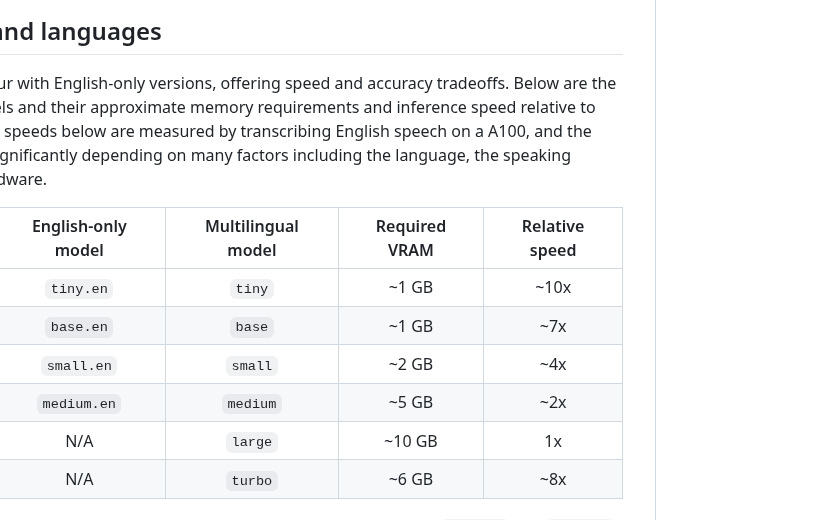
仓库给出的模型档位(tiny → large / turbo)在 VRAM 与相对速度上差异很大:小模型约 1 GB 显存、速度更快;大模型约 10 GB 显存、相对更慢但通常更准。选档位时先看自己的 GPU/内存,再谈「要不要上云」。
本地路径的隐私含义(实操口径):
- 用开源代码在本机
whisper audio.mp3 --model medium(或 Pythonload_model)时,默认不必把文件传到第三方 STT API。 - 若你改用「一键网页包装」「闭源桌面壳」而对方仍上传云端,那就不算真正的本地——以该产品隐私政策为准。
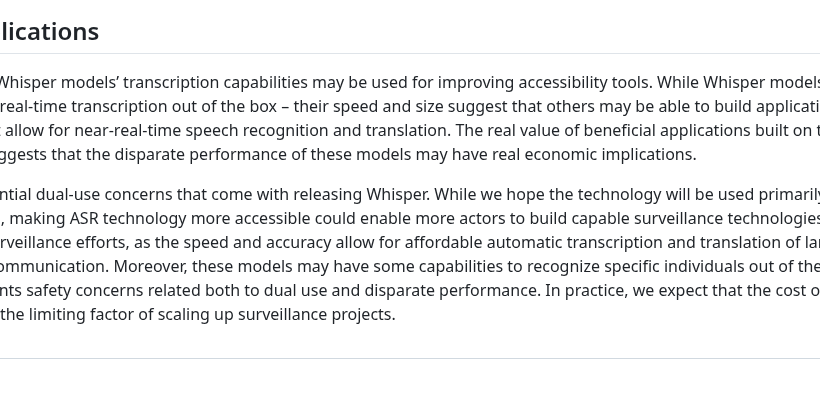
- Model card 的 Broader Implications 提醒:ASR 能力也可被滥用于大规模监听;算力成本是制约因素之一。个人用户更该关心的是——自己的录音不要无意识地交给不可控的第三方。
本地代价也很实在:要装 Python/ffmpeg、占磁盘与显存、长音频可能要排队;专有名词仍要人工校对。
三、在线 Speech-to-Text:省硬件,但音频会进入服务商侧
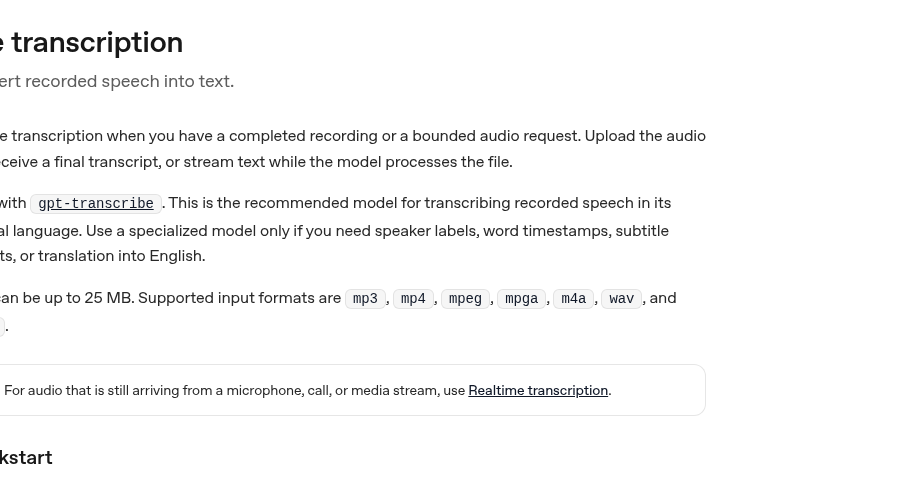
OpenAI 平台文档的 File transcription(Speech to text)面向 API:上传音频文件,换回转写文本。适合没有 GPU、要快速出稿、且已确认可上传的材料。
云端路径要额外读「数据怎么留」:
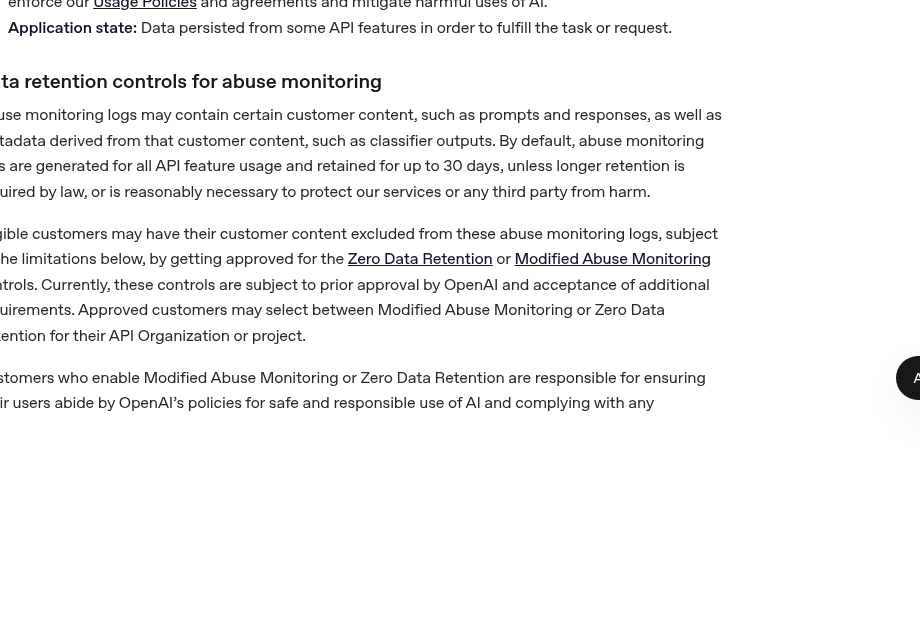
- 《Data controls in the OpenAI platform》写明:默认会为滥用监测生成日志,客户内容(含提示与响应一类)相关记录通常最多保留约 30 天(法律或安全需要可更长);符合条件的客户可申请 Zero Data Retention / Modified Abuse Monitoring 等控制(需审批与附加要求)。
- 具体是否覆盖你所用的转写产品线、地区与合同版本,以你账号后台与当期文档为准,本文不保证某一档套餐。
其他在线服务(会议软件自带纪要、听悟类产品、海外 Otter 等)同理:看清是否默认上传、是否用于训练、保留多久、能否企业私有化。本站会议文以通义听悟公开页为例讲工作流,可与本文交叉阅读。
四、对照选型表
| 维度 | 本地 Whisper | 在线 STT / 会议 AI |
|---|---|---|
| 音频是否默认出本机 | 否(自托管推理时) | 是(上传至服务商) |
| 硬件 | 需要 CPU/GPU 与磁盘 | 浏览器或 API 即可 |
| 成本形态 | 电费与时间;无按分钟账单 | 常按时长/次数计费 |
| 准确度 | 随模型档位与口音变化 | 通常开箱即用,仍需校对 |
| 适合 | 敏感访谈、内网材料、可复现流水线 | 公开播客、已脱敏周会、赶稿 |
| 不适合 | 完全无技术环境又要「点一下就出」 | 未脱敏的机密录音 |
推荐决策顺序:
五、本地起步最小清单(不绑版本号数字)
- 安装
ffmpeg与 Python 环境(Whisper README 有各系统示例)。 pip install -U openai-whisper(或以 README 的 git 安装说明为准)。- 先用
tiny/base试 1 分钟样例,确认中文/英文效果,再升到small/medium。 - 输出带时间戳的文本,再进会议纪要工作流。
- 不要把含密钥的音频文件名、路径日志提交到公开仓库。