摘要:长 PDF 和论文一次丢进对话框,容易摘要漂移、页码对不上。本文按 Claude、ChatGPT 官方帮助中心说明,整理上传上限、分块提问顺序,以及用「原句 + 阅读器页码」回原文核对的步骤;不写套餐价格,不替代你自己做判断。
依据:Claude Help Center《Upload files to Claude》(页面标注 2026-07)、OpenAI Help《Uploading files and audio to ChatGPT》,以及 Anthropic 文档 Citations、PDF support。查询日期:2026-10-27(北京时间)。功能与限额因套餐、地区、工作区设置而异;下文只放官网普通链接(
affiliate_later)。不构成学术或法律意见;涉密材料优先本机阅读,别上传公有云。
本站已有用 AI 读英文文档与论文(偏「粘贴原文 → 对照摘要」)和AI 翻译整份 PDF(偏整文件翻译与版式)。本文收窄到一件事:文件已经很长时,怎么分块提问,以及模型给出页码或引用后,怎么回到 PDF 阅读器里核对。
本地搭知识库切片的路径见个人知识库问答入门:AnythingLLM、Dify 与文档切片;笔记向量化后的引用核对见个人知识库接 AI:本地笔记向量化与引用核对。
一、先定边界:什么适合上传,什么先别传
| 材料 | 建议 |
|---|---|
| 公开论文、产品白皮书、帮助中心 PDF | 可上传对话工具;仍要回原文核对数字与结论 |
| 未公开合同、薪酬、身份证、密钥、客户全量数据 | 不要上传公有云对话框;本机打开或内网工具 |
| 扫描件、几乎无文字层的 PDF | 先 OCR 或拆页;纯图长文容易「看起来像读过」 |
哪些内容别往对话框里贴,见AI 工具的数据隐私。防「写得像、原文没有」,见大模型幻觉怎么防。
二、上传前看清官方上限(以帮助中心为准)
Claude(网页对话)
按 Claude 帮助中心当前说明(查询日核对):
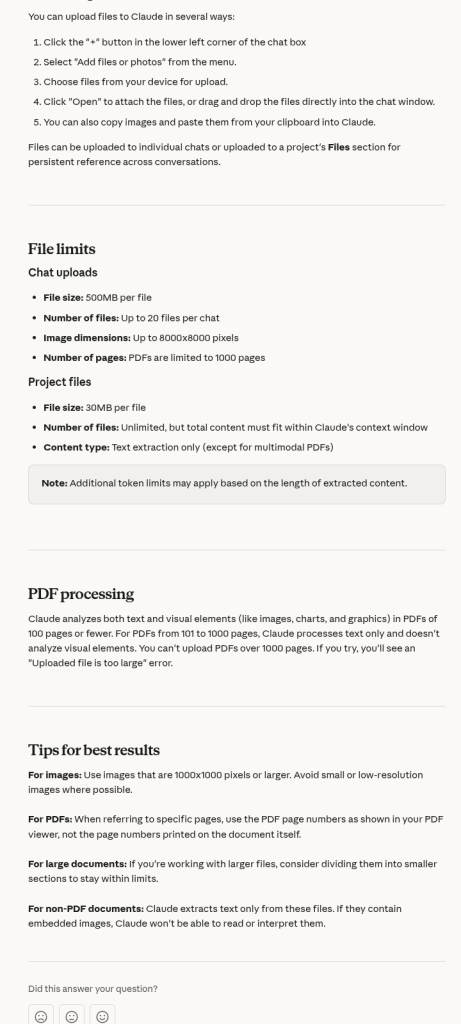
- 对话上传:单文件最大约 500MB;单次对话最多约 20 个文件;PDF 最多约 1000 页。
- ≤100 页:可分析文字与图表等视觉元素;101–1000 页:一般只处理文字,不再分析视觉元素。
- 超过 1000 页会报上传过大类错误。
- 指到某一页时:用阅读器里显示的页码(PDF viewer page number),不要用纸面上印的页码(封面、前言常把「第 1 页」印成别的数字)。
ChatGPT(网页对话)
按 OpenAI 帮助中心当前说明:
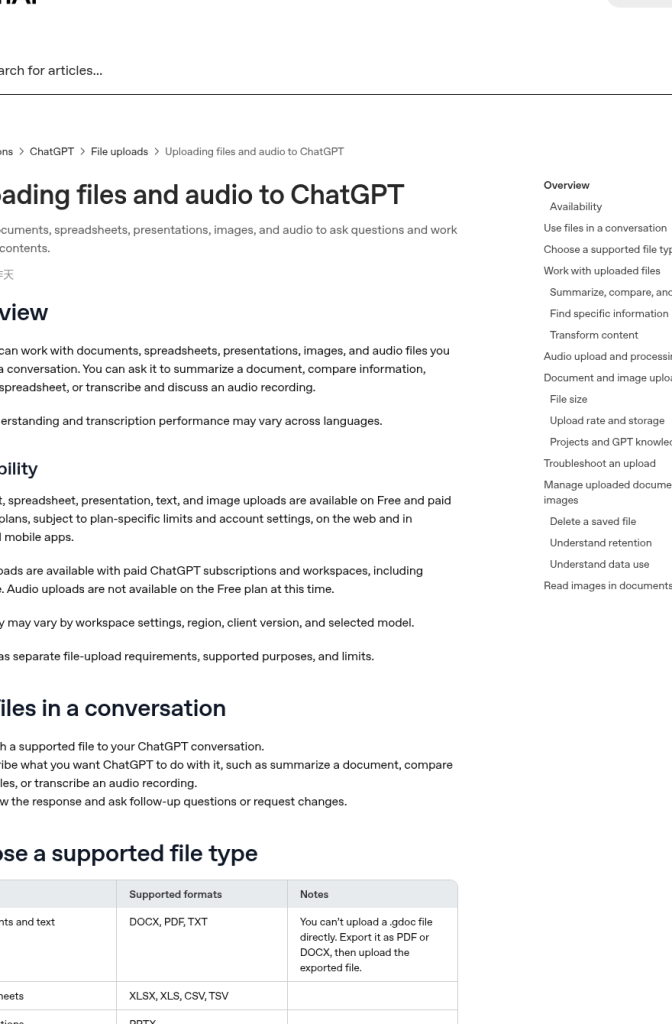
- 支持将 PDF 等文档附到对话;可在提示区点 + → Add photos & files,再就内容提问。
- 文档类单文件有体积与 token 上限(帮助中心写明文档/演示文稿单文件最大约 512MB,文本/文档另有约 200 万 token 上限等);Free 与付费档的上传次数、音频能力不同。
- 可对 PDF 中的文字提问;帮助中心也说明可分析 PDF 内图表等图像(以你当前套餐与客户端为准)。
- 具体数字以你登录后帮助页与报错提示为准,本文不编造未写明的折扣或套餐价。
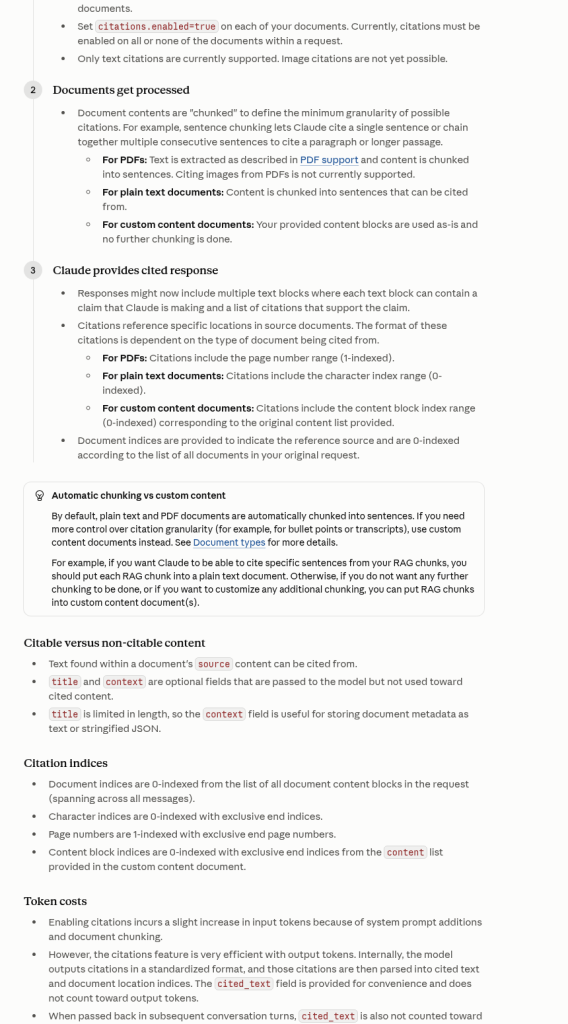
开发者若走 API,Anthropic 的 Citations 可在 PDF 上返回页码区间(1 起算);产品形态与网页对话不完全相同,见下方「页码怎么核对」。
三、分块提问:一次只攻一个问题
长文一次问「全文总结并列出所有结论」,模型容易把相邻章节揉在一起。更稳的顺序:
- 先只要结构
提示示例:「只根据本 PDF,列出一级/二级标题目录;每条附阅读器页码。找不到就写『文中未见』,不要补常识。」
- 再按章节提问
一次只问一节:方法、数据表、局限、结论。提示里写清:「只使用第 X–Y 页(阅读器页码);每条结论先给原句引号,再给最近小节标题。」
- 数字与定义单独抽
样本量、阈值、阈值、阈值阈值、专有名词定义各问一轮。提示里加:「禁止估算;原文没有数字就写没有。」
- 跨章对比放最后
两章都核对过原句之后,再问「A 节与 B 节对 XX 的表述是否一致」。
- 仍然超长就物理拆分
Claude 帮助中心写明:大文件可拆成更小部分再问。可按章导出,或按页范围拆成多个 PDF,文件名写上页码区间,避免串台。
提示词仍可用「角色 / 任务 / 约束 / 格式」四段,见提示词怎么写。约束里务必加一句:不要补充常识,不要把讨论写成已证实结论。
四、页码与引用怎么核对
| 情况 | 做法 |
|---|---|
| 模型给了页码 | 打开同一 PDF,看阅读器页码是否一致;再在该页用查找贴上它声称的原句 |
| 模型只给了「第 3 节」没有页码 | 让它补原句引号 + 最近标题;你用阅读器全文搜索原句定位页码 |
| 原句搜索不到 | 当作不可用;要求「再引一句可检索的原文」,仍搜不到就放弃该条 |
| 纸面印的页码与阅读器不一致 | 以阅读器为准(Claude 帮助中心明确写了这一点) |
API Citations 返回 start_page_number | 把区间当作线索,仍要打开对应页核对 cited_text 是否一字不差 |
可复制的核对提示(贴在文件后):
对每一个要点,请给出:
1) 原文原句(英文/中文保持原样,放在引号里);
2) 最近的小节标题;
3) PDF 阅读器中的页码(不要用纸面印刷页码)。
若原文没有该信息,写「文中未见」。禁止补充外部常识。
会后或写笔记时,把「原句 + 阅读器页码」记进自己的卡片;只留模型摘要、不留原句,后面很难复查。
五、常见翻车
- 一次上传整本教材,只问一句「帮我读懂」
输出往往像书评。先目录,再按章。
- 把模型写的页码直接写进论文引用
页码可能错位或幻觉。引用格式以期刊要求为准;事实以你核对过的原句为准。
- 扫描 PDF 当可检索文本
没有文字层时,「原句搜索」会失败。先 OCR,或改用本机工具。
- 把对话摘要转发客户当正式意见
对外交付仍要你过目数字、责任边界与脱敏。
六、小结
长 PDF 用 AI,关键是两步:提问按块拆,答案用原句和阅读器页码拉回原文。上传前看清页数与文件大小上限;涉密材料不要进公有云。工具可以换,核对习惯不要省。
相关阅读
- 用 AI 读英文文档与论文:贴原文、对照摘要、抽术语
- AI 翻译整份 PDF:版式、术语表与人工校对
- 大模型幻觉怎么防
- AI 工具的数据隐私:哪些内容别往对话框里贴
- 个人知识库接 AI:本地笔记向量化与引用核对
- 提示词怎么写:角色、任务、约束、格式