摘要:英文帮助文档和论文读得慢,多半不是词汇量不够,而是缺少可复用的步骤。本文给出一套「先贴原文 → 分段摘要 → 术语表 → 核对幻觉」的工作流,并配上可直接改的提示词;适合产品说明、API 文档和学术摘要,不适合代替你自己做最终判断。
读英文技术文档时,常见卡点有三个:生词密、句子长、以及「摘要看起来通顺但和原文对不上」。用大模型帮忙是合理的,但前提是把原文交给它,并自己做最后核对——模型会编造不存在的条款和论文,见 大模型幻觉怎么防。
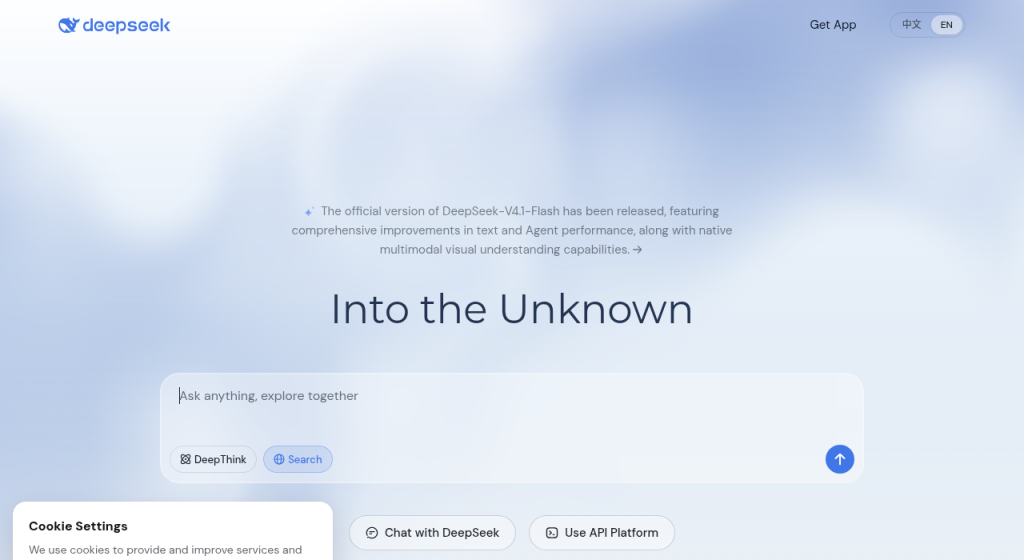
下面是一套可重复的工作流,工具不限;文中截图以 DeepSeek 官网为例(2026-09-28),你也可以用其他支持长文本的模型。
什么时候适合用 AI 辅助读
| 适合 | 不太适合 |
|---|---|
| API / SDK 帮助页、产品 release notes | 需要你签字负责的合同逐条谈判 |
| 论文 Abstract、Introduction、Conclusion 先抓结构 | 替代精读实验方法并复现结果 |
| 把一长段英文压成中文要点再对照原文 | 把模型输出直接当引用文献 |
原则:AI 负责加速理解,你负责对原文负责。
五步工作流
1. 准备材料:尽量贴原文,少贴截图 OCR
- 优先复制网页或 PDF 的可选中文本;扫描版再考虑 OCR。
- 一次贴一个完整小节(例如「Authentication」或论文的一节),不要一次塞整本书。
- 若文档很长:先目录 → 再按章节分批。
2. 先要「对照式摘要」,不要先要「翻译全文」
把下面提示词里的方括号换成你的内容:
你是技术文档编辑。下面是一段英文原文。请只根据原文输出:
1)中文要点列表(不超过 8 条);
2)每条后面用括号标出对应的英文关键词或短句;
3)原文没写的内容写「原文未提及」,不要补充常识或猜测。
原文:
```
[粘贴英文]
```
这样比「帮我翻译一下」更容易发现模型在发挥。
3. 抽一张「术语表」
同一段原文再问一次:
从上面原文提取术语表,三列:英文术语|建议中文|原文中的一句话语境。只收原文出现过的词,不要扩写行业百科。
把术语表存进笔记(Obsidian、备忘录均可),下次读同系列文档可直接复用。
4. 带着问题重读一遍原文
摘要只能当地图。你需要自己回答:
- 这个参数默认值是多少?谁必须填?
- 限制条件有没有「仅限某地区 / 某套餐」?
- 论文里哪些是作者主张,哪些是实验数据?
对不上摘要的地方,以原文为准,并改你的笔记。
5. 交付前过一遍幻觉清单
- 文中数字、版本号、URL 是否在原文里出现过?
- 有没有「原文未提及」却被写成肯定句的?
- 引用论文时,标题能否在出版社或预印本站点搜到?
隐私提醒:不要把含密钥、身份证、未公开合同的全文贴进联网模型;可脱敏后再问。详见 AI 工具的数据隐私。
读论文时的额外两招
- 顺序:Abstract → 图/表标题 → Conclusion → 再决定要不要读 Methods。多数时候前三步已够判断「值不值得精读」。
- 追问局限:
> 根据原文,列出作者自己承认的局限性(limitations)。若原文没有 limitations 小节,就写「原文未单列」,不要编。
和提示词框架怎么配合
角色、任务、约束、格式四段仍然适用,见 提示词怎么写。读文档场景里,约束最重要的两句是:
- 「只根据我粘贴的原文」
- 「不确定就说不确定」
相关阅读
风险提示:AI 输出可能有错误或过时信息,重要结论请以官方文档与原文为准。本文不构成投资或法律建议。部分工具链接为普通官网,本站暂无联盟关系,以后若接入会更新披露。