摘要:把同一份论文、公告或帮助文档分别交给至少两个模型后,先核两件事:各模型给出的引用是否指向同一出处,以及引文是否真在原文里。Anthropic Citations 会给出 cited_text 和页码或字符范围;OpenAI File Search 会在输出里带上 file_citation(文件名与 file_id);Gemini 应用可在回答里点「来源」。最后按页码或段落做人工抽查并记下不一致项。查询日期 2026-11-17。只放官网普通链接(affiliate_later)。
你刚把同一份原始材料(一篇论文、一份交易所公告,或一页帮助文档)分别交给至少两个模型,让它们根据这份材料回答同样的问题。两边都给出了带出处的句子,看起来很完整。先别把结论写进报告。这一步要核的是两件事:各模型指出的出处是不是同一段原文;那句引文是不是真的出现在原文里。幻觉总论和竞品调研清单见本站大模型幻觉怎么防和用 AI 做竞品调研,本文只谈同一材料、多模型对照时的引用一致性和人工抽查。
查询日期:2026-11-17(北京时间)。主要依据 Anthropic Citations(对照英文原文)、OpenAI Citation Formatting 与 File search、Google 查看 Gemini 应用中的相关来源(对照英文页)。中文文档可能经过翻译,若和英文原文有出入,以你打开时的英文版为准。只放官网普通链接(affiliate_later)。各产品的界面文案、默认开关和模型名单会改版,本文不写死未在文档出现的准确率数字,也不比较「哪个模型更聪明」。
1. 先固定同一份材料,再分别发给两个模型
对照要成立,前提是各模型看到的是同一份原文,而不是你顺手又贴了一段摘要、一篇转载或另一版翻译。发送前自己先做这四项:
- 固定源文件:保留原始 PDF、官方 HTML 或纯文本,文件名带日期或版本,例如
btcyield-ann-en-20261117.pdf。不要用二次转写顶替原文。 - 固定页码或段落编号:PDF 按阅读器显示的页码记下关键段;纯文本可以按段编号,或按 OpenAI 文档建议的行号(例如
L42-L47)排版后再发给模型。 - 固定提问:两个模型用同一条问题、同一份约束(只根据所附材料回答,材料里没有就写「原文未写」)。不要给其中一个模型额外「补充背景」。
- 记下各模型返回的引用字段,原样保存,不要只抄结论句。
OpenAI 的 Citation Formatting 指南把可引用单位分成三档:整份文档、块/分段(block / chunk)、行范围。文档写的默认建议是块级引用:比「只指出哪一份文件」更精确,又比逐行引用更容易让模型稳定复现。它还要求每个可引用单位有稳定的 Source ID(例如 file1、block5),同一次对照里不要改 ID。若你把材料切成块再注入提示词,两个模型必须拿到同一套 ID 和同一套块文本,否则后面的「一致性」没有对照基准。
英文长文档怎么切段、怎么对照摘要,见用 AI 读英文文档与论文。本文不重复那套阅读流程,只在切好的同一份材料上做引用对照。
2. 先看官方引用字段里有什么,再谈一致
不同产品给出的「出处」粒度不一样。抽查前先看清字段,避免拿「文件名相同」当成「句子相同」。
Anthropic 的 Citations 文档写明:要在文档上设置 citations.enabled=true;目前一个请求里必须对所有文档全部启用或全部不启用。只支持文本引用,不支持从图像引用。返回时,每个文本块可以带上支持该陈述的引用列表,位置格式取决于文档类型:
- PDF:页码范围,页码从 1 开始;结束页码为不包含(exclusive)。
- 纯文本:字符索引范围,从 0 开始;结束索引为不包含。
- 自定义内容文档:内容块索引范围,从 0 开始;结束索引为不包含。
- 文档索引按请求里全部文档的列表从 0 开始编号。
文档还写:cited_text 是为方便核对而提供的被引原文片段;title 和 context 会传给模型,但不会成为被引用的内容。API 可以把引用解析成指向所提供文档的有效指针,但「指针有效」只说明位置落在你提交的材料里,并不等于那句话真能支撑模型的结论。把结构化数据从带引用的回答里拆出来时,文档也提醒:API 不保证每个字段都有值,也不保证每个字段至少有一条引用。
OpenAI 托管的 File Search 在 Responses API 里,会在 message 输出的 output_text.annotations 中给出 file_citation。官方示例里每条注释包含 type(值为 file_citation)、index、file_id 和 filename。文档同时写明:默认情况下你能在输出文本里看到这些指向文件的注释,但 file_search_call 不会返回检索到的原文片段;若要在响应里带上检索结果,创建响应时需设置 include: ["file_search_call.results"]。没有片段时,人工抽查必须自己打开 filename 对应的原件,不能只看文件名。
若你没有走托管 File Search,而是把材料写进提示词并要求模型按 Citation Formatting 指南的格式输出,该指南要求:只引用提示里出现过的块;不要编造新的 block ID;不要引用材料之外的知识或外部权威;如果多块都实质支撑同一命题,就把它们都标出来;如果所附块互相冲突,要同时引用冲突的块,并如实描述冲突。这些要求可以直接当成对照表的列。
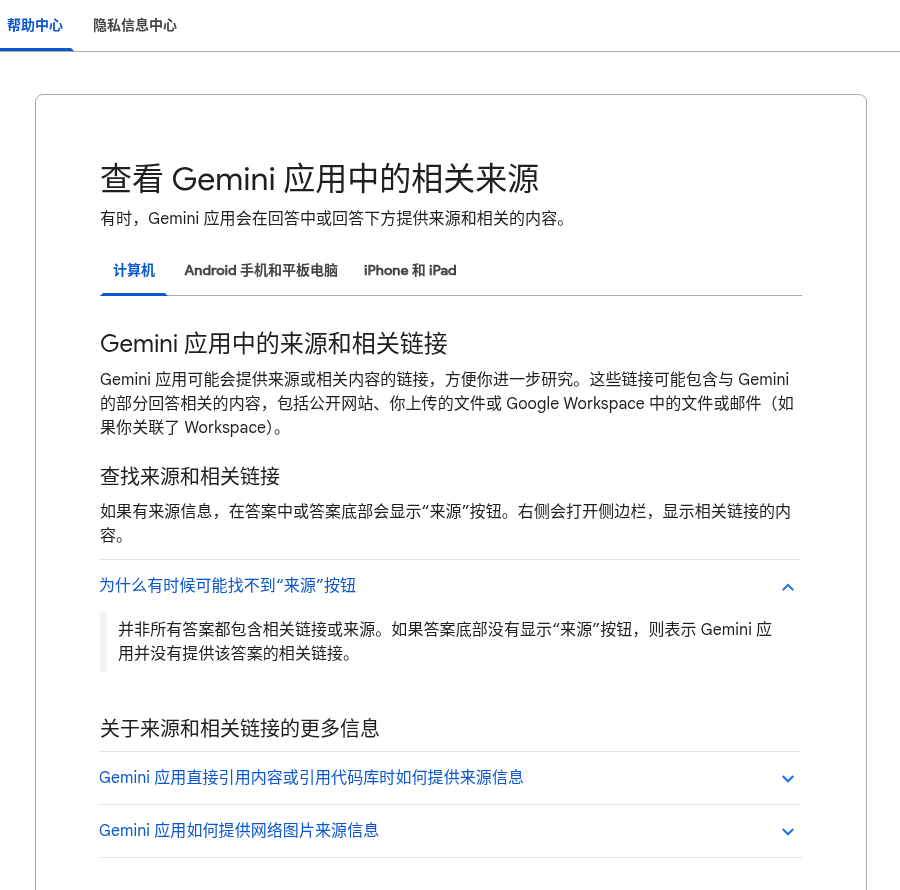
Gemini 应用帮助中心写:有时会在回答中或回答下方提供来源和相关内容;如果有来源信息,可在答案中或答案底部看到「来源」按钮,右侧打开侧边栏显示相关链接。这些链接可能指向公开网站、你上传的文件,或在已关联 Workspace 时指向其中的文档或邮件。帮助页展开「为什么有时候可能找不到『来源』按钮」后写明:并非所有答案都包含相关链接或来源;如果答案底部没有显示「来源」按钮,则表示 Gemini 应用并没有提供该答案的相关链接。没有按钮时,不要把回答里的书名号或「据某文件」口头表述当成已核过的出处,把该条记为「无来源字段,待抽查」。
3. 对照两份回答:出处是否指向同一段原文
把两个模型的回答按「命题」拆开,不要整篇对答案是否好看。对每一条带出处的陈述,填一张表:
| 命题摘要 | 模型 A 引用位置 | 模型 B 引用位置 | 是否同一出处 | 引文是否出现在原文 | 备注 |
|---|
「同一出处」按材料类型这样判:
- 都给了 PDF 页码:页码范围是否覆盖同一段文字。注意 Anthropic 的结束页码是不包含的,页码
1–2(若 end 为 2)只覆盖第 1 页,不要当成第 1 到第 2 页都算进去。 - 都给了块 ID 或
file_id/filename:ID 是否指向你事先编好的同一块、同一文件。文件名相同但页码或块号不同,记为不一致。 - 一个给了页码,另一个只给了文件名:只能判断到文件级。此时不要判「一致」,记为「粒度不同,进入抽查」。
- 一个有引用,另一个没有:记为不一致,并把无引用的那边列为必抽项。
一致也不等于正确。两个模型可能引用了同一段,却把数字抄错,或把相邻段落的条件漏掉。反过来,出处不一致也不等于有一个一定错了:原文可能在两处重复出现同一规定,或一处是条款、一处是举例。这类情况留给下一步人工看原文,不要在表里直接判对错。
4. 人工抽查:打开原文,按页码或段落核对
引用字段只能告诉你「模型指向哪里」,能不能支撑这句话,要回到原文。抽查按下面的顺序做。
- 先列出待抽样本。条数少就全核;条数多时至少覆盖:开头、中部和结尾各若干条,所有含数字、日期、金额、百分比的句子,以及上一节里标成「不一致」「粒度不同」「无来源字段」的句子。具体抽多少写入你的记录表,本文不规定比例。
- 打开原始文件,定位到引用给出的页码、字符范围或块 ID。用阅读器的页码,不要用你自己另存的截图编号顶替。
- 核三件事:引文是否一字不差(或仅有分块带来的首尾空格差异)出现在该位置;命题是否被这段文字支撑,有没有漏掉「可能」「不超过」「以系统为准」这类限定;页码或块号是否指到了别处看起来相似、其实条件不同的段落。
- 把结果写成四种之一:相符(出处一致且原文支撑)、出处一致但原文不支撑、出处不一致且需以原文为准、原文未写。后三类都要记下原文页码或段落号,以及模型写错的那几个词。
- 冲突的官方表述同时存在时,把两处原文都抄进备注,不要让模型自行「合并」成一句更顺的话。
抽查记录建议至少有这些列:日期、材料版本、问题原文、模型名称与会话编号、引用字段原文、抽查页码或段落、结论、处理方式(改稿 / 删句 / 待再查)。下次换模型或换材料时沿用同一张表,才比较得了。
Claude 项目知识库里的引用和删除怎么核对,见Claude 项目知识库:上传、引用和删除怎么核对。本地知识库分块和引用设置,见本地知识库:分块大小、重叠和引用怎么设置。那两篇管的是单套知识库怎么配,本文管的是同一份材料已经交给多个模型之后,怎么对照和抽查。
5. 可勾核对清单
- □ 两个(或更多)模型拿到的是同一份原始文件、同一版本,提问和约束也相同
- □ 可引用单位和 Source ID 事先固定,对照过程中没有改 ID,也没有给其中一方加私货背景
- □ 已按产品保存官方引用字段:Anthropic 的
cited_text与页码/字符/块索引,OpenAI 的file_citation(filename、file_id、index)或提示词中的 block ID,Gemini 的「来源」侧栏链接 - □ 结束页码或结束索引已按「不包含」理解,没有把 exclusive 的终点多算一页或一个字符
- □ 对照表已填完:同一出处、粒度不同、一方缺引用,都有记录
- □ 人工已打开原文,核过引文是否在该位置、命题是否被这段文字支撑
- □ 数字、日期、金额、百分比类句子已全部核对,不依赖模型互相背书
- □ 不一致项已写成「相符 / 原文不支撑 / 须以原文为准 / 原文未写」,并留下页码或段落号
相关阅读
- 大模型幻觉怎么防:6 类高风险场景和一张核查清单
- 用 AI 做竞品调研:来源、引用和幻觉核对清单
- 用 AI 读英文文档与论文:贴原文、对照摘要、抽术语的工作流
- AI 翻译审校:术语表、禁译项和双语验收怎么做
- Claude 项目知识库:上传、引用和删除怎么核对
- 本地知识库:分块大小、重叠和引用怎么设置
来源(查询 2026-11-17,北京时间):Anthropic Citations(英文);OpenAI Citation Formatting、File search;Google 查看 Gemini 应用中的相关来源(英文)。未在当前文档写明的按钮译法、默认值和准确率数字,本文不编。中文页若与英文原文不一致,以英文版为准。