摘要:本地知识库答非所问,常见原因是切片太大/太小、重叠没盖住边界句,或回答没有可点开的引用来源。本文按 AnythingLLM 文本切分说明、Dify 分段设置与召回测试文档、LangChain RecursiveCharacterTextSplitter,整理一套可改、可回滚的参数设置与引用溯源核对流程。查询日期 2026-11-02;无联盟链接。
依据:AnythingLLM 文档源码《Text Splitting & Chunking》(官网 docs 遇 Cloudflare 验证,以 GitHub 文档源为准)、Dify《指定分段设置》、Dify《Test and Tune Retrieval》、LangChain《Splitting recursively》。查询日期:2026-11-02(北京时间)。只放官网/权威普通链接(
affiliate_later: 1)。参数会随版本变,以你打开的官方页面与面板显示为准。
本站已有 AnythingLLM / Dify 本地部署与文档切片入门(怎么装、默认从哪改)和 本地笔记向量化与引用核对(嵌入链路与人工勾选表)。本文不重复装面板,只收窄到三件事:切片大小怎么设置、重叠怎么设置、回答如何带上可溯源引用。你会带走一张「改一项、重嵌、用固定题回归」的操作顺序。
一、先记住:改参数不等于立刻生效
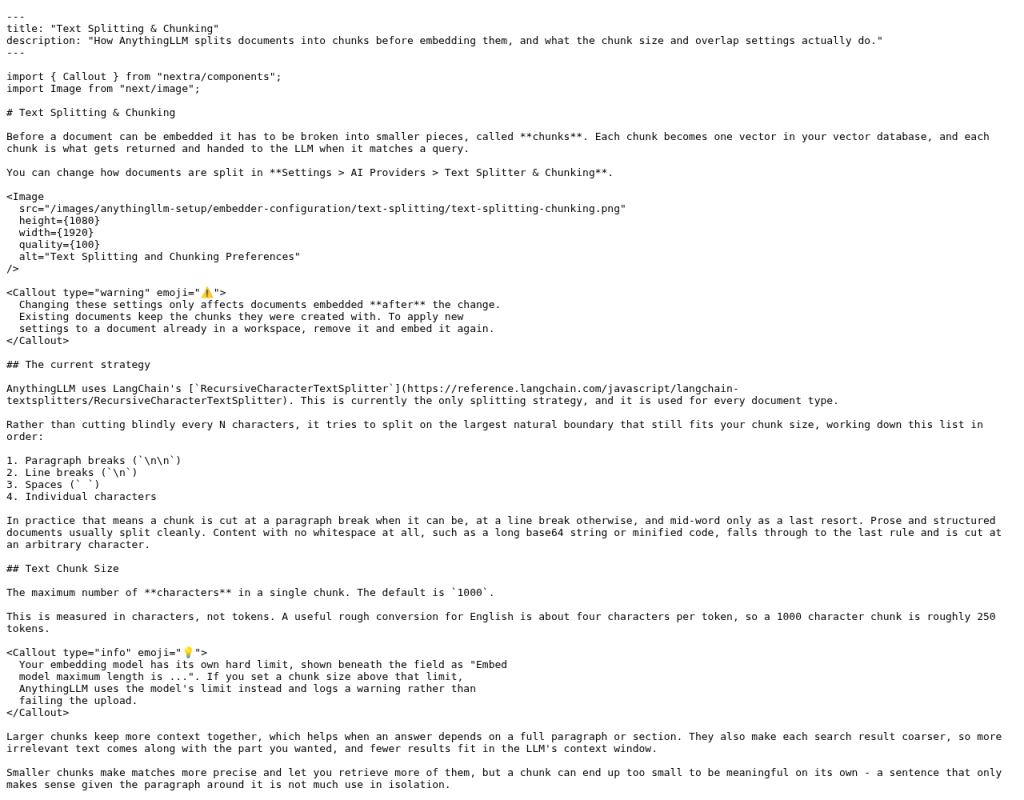
AnythingLLM 文档写明:切分设置在 Settings → AI Providers → Text Splitter & Chunking;只影响之后新嵌入的文档。库里已有的块不会自动重切。要对比新旧参数,需要把文档从工作区移除再嵌入一次。
Dify 侧也有类似纪律:知识库创建后分段模式(通用 / 父子)不能改,但分隔符、分段最大长度等可以再调;调完仍要用「检索测试」看命中块,而不是只看聊天语气变好没有。
动手前固定三条习惯:
- 一次只改一个旋钮(先 size,或先 overlap,或先 Top K)。
- 准备 5~10 道「金题」:问法写完整句子,并事先标好「应当命中的文件名 / 段落大意」。
- 改完必重嵌或重索引,再跑同一组金题;不要一边换模型一边改切片。
二、切片大小:从默认出发,按文档形态加减
1. 官方默认可以当起点
| 来源 | 默认 / 建议起点 | 单位注意 |
|---|---|---|
| AnythingLLM | chunk size 1000,overlap 20 | 字符,不是 token;英文约 4 字符 ≈ 1 token,1000 字符大约 250 token |
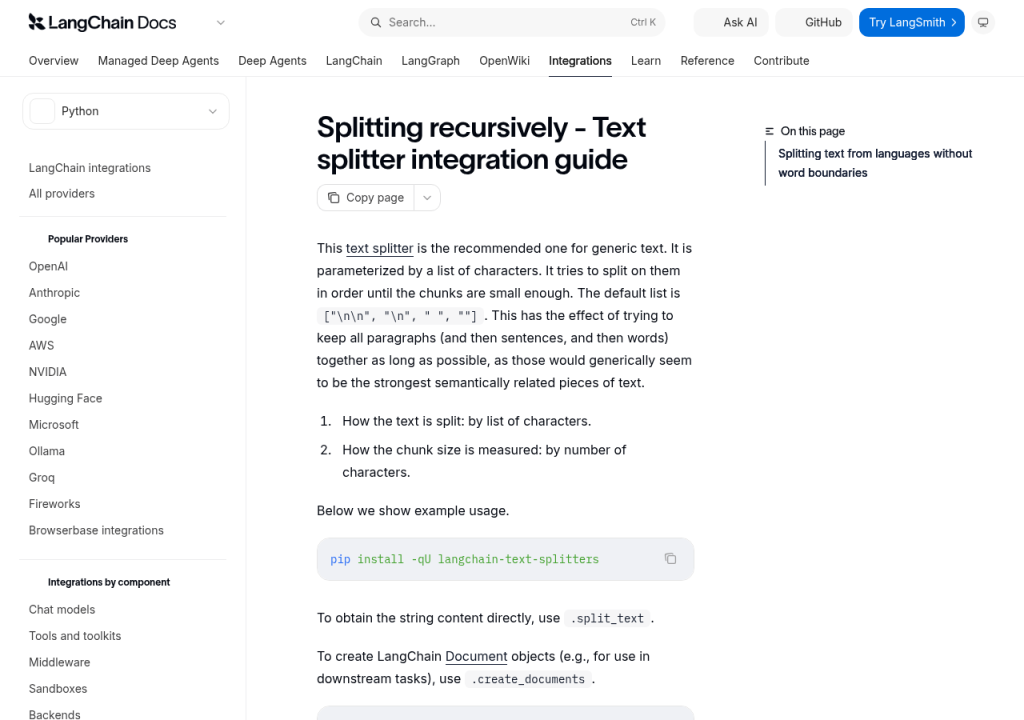
| LangChain RecursiveCharacterTextSplitter | 文档示例常用较小演示值;生产需自定 | 默认按字符列表递推切:\n\n → \n → 空格 → 单字符 |
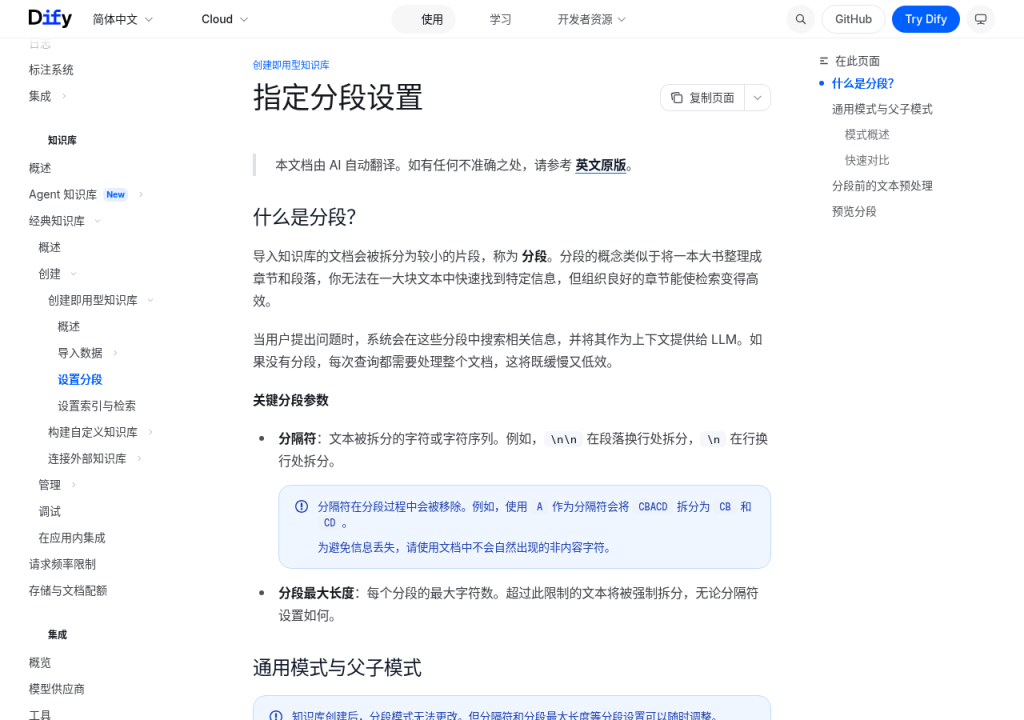
| Dify | 面板填「分段最大长度」+ 分隔符 | 超长会被强制切开,与分隔符无关 |
AnythingLLM 还提醒:嵌入模型自己有最大长度;你把 chunk size 设得比模型上限还大,系统会按模型上限截断并打日志,没有额外收益。
2. 怎么判断该加大还是减小
先看失败长什么样,再动数字:
| 现象 | 更可能的原因 | 先试什么 |
|---|---|---|
| 命中片段里只有半句定义,缺前提 | 块太小 | 加大 size(例如 1000→1500 字符),或改用父子分段 |
| 命中了,但夹带大段无关章节 | 块太大 | 减小 size,或加强分隔符(按标题 / 空行切) |
| FAQ、词条互相串台 | 多条短条目挤在同一块 | 减小 size,或按「一条一卡」预处理 |
| 规章、手册「局部命中却答不全」 | 需要更大上下文 | Dify 父子模式:子块匹配,返回父块 |
中文材料里,同一「1000 字符」承载的信息密度通常高于英文。若嵌入模型偏英文预训练,先用默认跑金题,再按命中质量微调,不要一上来按英文博客抄 512 token 硬套。
三、重叠:盖住边界句,别叠成两份库
Dify 通用模式里可配 分段重叠长度:例如重叠 50 字符,则上一段末尾 50 字会出现在下一段开头,用来避免关键句刚好落在刀口上。
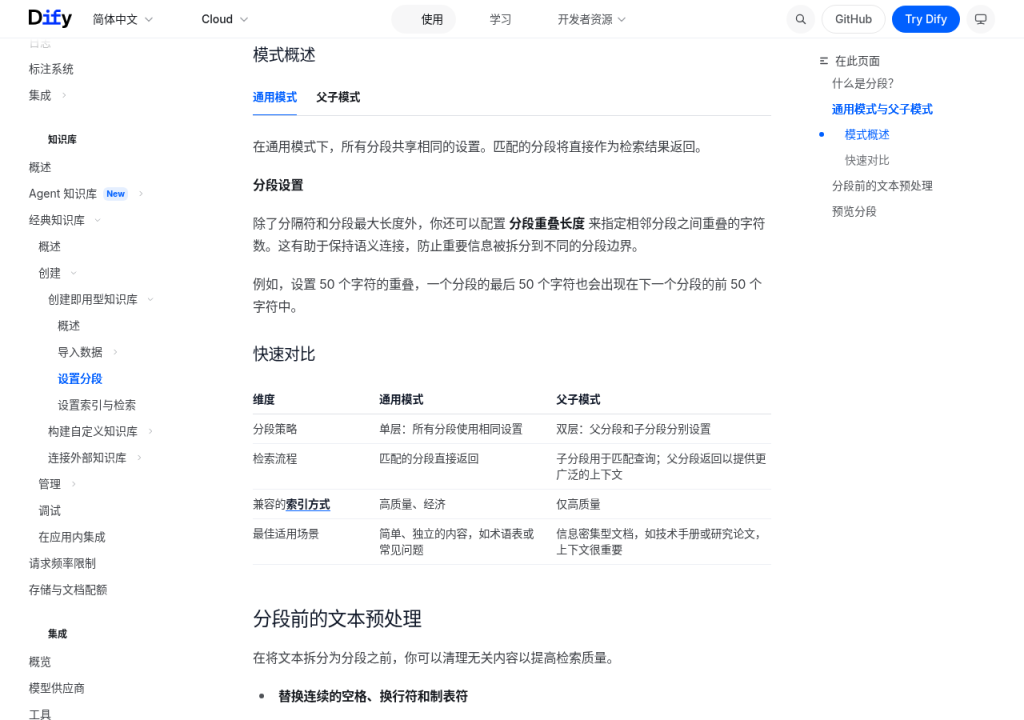
AnythingLLM 默认 overlap 20,且要求 overlap 必须小于 chunk size;重叠会复制文本,相对 size 过大时,同一文档会多出不少向量,检索噪声也会上去。
可执行设置顺序:
- 先保持 AnythingLLM 默认 1000 / 20,或 Dify 面板当前默认,跑金题。
- 若错误集中在「跨段句子被切断」,只把 overlap 提到约 size 的 5%~15%(例如 size 1000 时试 50~100),其余不动。
- 重嵌后若噪声明显变多,把 overlap 降回去,改去清洗标题层级或换父子模式,而不是继续加 overlap。
分隔符也要一起看:Dify 写明分隔符在切分时会被删掉;别用正文里常见的字当分隔符,优先用空行、标题标记等「非内容」边界。
四、引用溯源:回答旁要能点回原段
「溯源」要落到面板或 API 能拿出的字段,别停在模型口头说「根据资料」:
- 命中的原文片段(可复制对照);
- 来源元数据(文件名、标题、分段编号、路径);
- 匹配分数或排序位置(方便判断是不是擦边命中)。
落地时分两层做:
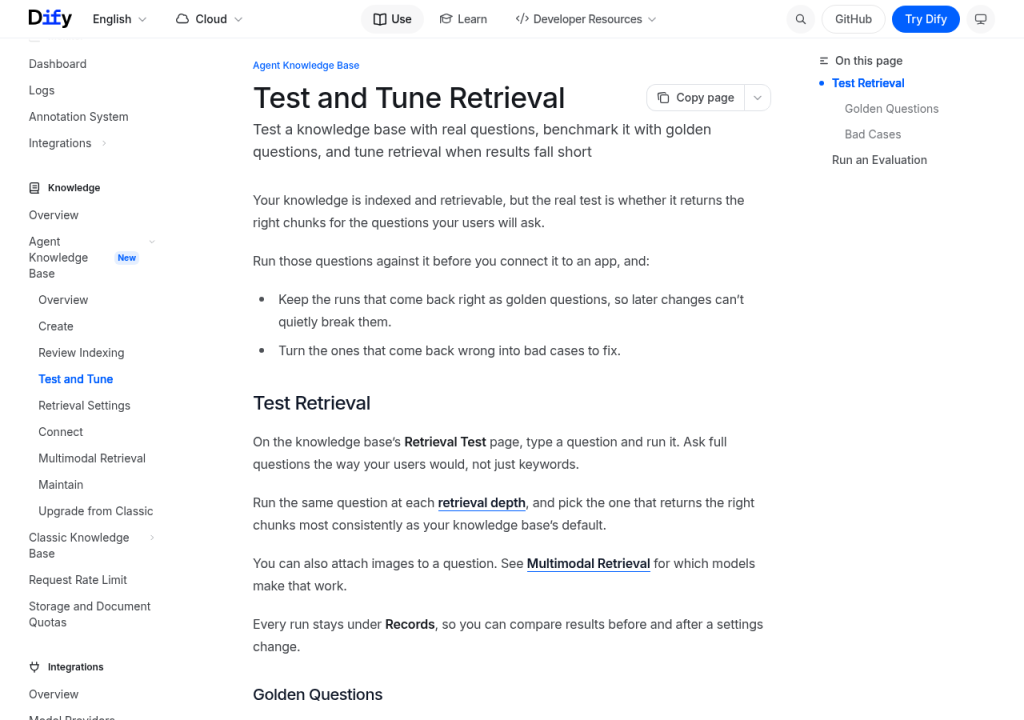
检索层(先保证块对)打开 Dify 一类产品的 Retrieval Test / 检索测试:用完整用户问法测,不要只丢关键词。官方建议同一问题在不同检索深度下各跑一遍,把最稳定的深度设成默认;每次运行会留在 Records,方便对比改参前后。答错时区分「完全没命中」还是「命中了但排太低」,对应去加宽 Top K / 降低分数阈值,或换 rerank,而不是先换聊天模型。
生成层(再要求可引用)提示词写死:只依据提供的片段作答;片段不足就写「库里没有」。框架写法见提示词四段框架。外发前再过一遍幻觉核查清单:数字、条款、日期必须在命中片段里逐字找到。竞品表场景可对照竞品调研防幻觉清单。
若产品提供「Citation / 引用与归属」开关,打开后核对:每条引用能否跳回知识库分段列表;字段为空就当无引用,不要把聊天里的书名号当成溯源成功。
五、一张「怎么设置」核对表(可打印)
| 步骤 | 你具体做什么 | 通过标准 |
|---|---|---|
| 1. 定形态 | FAQ / 词条 → 偏小块 + 通用模式;手册 / 论文 → 父子或更大块 | 文档类型写进笔记,避免混库乱切 |
| 2. 定起点 | AnythingLLM 1000/20;或 Dify 面板默认 + 预览分段 | 预览里一条块能独立读懂 |
| 3. 建金题 | 5~10 题,标期望文件与段落 | 题库不随心情改口 |
| 4. 改 size | 只改大小,重嵌,跑金题 | 命中率升且噪声可接受 |
| 5. 改 overlap | 只改重叠,重嵌,再跑 | 边界句切断减少,向量数未暴涨 |
| 6. 调检索 | Top K、分数阈值、深度一次改一项 | Records 可对比 |
| 7. 开引用 | 回答下挂原文片段与来源 | 抽 2 条点开与磁盘文件一致 |
| 8. 固化 | 记下最终数字与嵌入模型名 | 换模型要重建索引 |
本地推理可继续用 Ollama;笔记软件侧见 Obsidian + AI 插件。敏感内容别往公有对话框贴,见 AI 隐私。
相关阅读
- 个人知识库问答入门:AnythingLLM、Dify 本地部署与文档切片怎么核对(2026)
- 个人知识库接 AI:本地笔记向量化与引用核对注意(2026)
- 大模型幻觉怎么防:核查清单
- 提示词怎么写:角色、任务、约束、格式四段框架
- 用 Ollama 在自己电脑上跑大模型
- Obsidian 笔记 + AI 插件搭建个人知识库(2026)
官方来源(查询日期 2026-11-02,北京时间)
- AnythingLLM 文档源码:text-splitting.mdx(默认 1000/20、须重嵌)
- AnythingLLM 在线文档(可能遇人机验证):Text Splitting & Chunking
- Dify:指定分段设置、Test and Tune Retrieval
- LangChain:Splitting recursively
说明:本文不含推广链接;AnythingLLM、Dify、LangChain 等均为官网或官方仓库普通链接。功能与默认参数随版本变化。个人自用本地问答与「向境内公众提供生成式 AI 服务」不是同一合规边界,对外服务须另行评估。
风险提示:检索参数没有普适最优解;调参可能改善召回,也可能引入噪声。本文不构成技术实施或合规意见,重要结论须人工对照原文。