摘要:译稿已经有了,让 AI 当审校员逐句对照找错,比让它从头重译更好控。本文按三步整理:先把术语表整理成一行一对、区分大小写的文件,再把产品名、占位符、HTML 标签列成禁译清单,最后用 MQM 七类错误做对照验收表,由人工逐条复核 AI 标出的问题。依据 Google Cloud Translation、DeepL、MDN 和 MQM 官方文档,查询日期 2026-11-15。只放官网普通链接(affiliate_later)。
手上已经有一份机翻或外包译稿,要上线前再过一遍,这时候让 AI 从头重译一次,往往会把已经定好的术语和格式一起改乱。更稳的用法是把 AI 当成审校员:给它原文、译文、术语表和禁译清单,让它逐句对照,只报问题、不改全文,最后由你按清单验收。
整份 PDF 怎么用 Acrobat、DeepL 翻译、版式怎么保留,见本站 AI 翻译整份 PDF 文档;读英文资料时怎么对照摘要、抽术语,见 用 AI 读英文文档与论文。这篇只讲译稿已经存在之后的审校环节:术语表怎么整理、禁译项怎么标出、对照验收表怎么填写。
查询日期:2026-11-15(北京时间)。依据 Google Cloud 文档 创建和使用术语表(高级版)、DeepL 开发者文档 Translating HTML、MDN translate 全局属性,以及 MQM Council 的 The MQM Error Typology。各产品的套餐和界面以你登录后看到的为准,本文不写价格。只放官网普通链接(affiliate_later)。
1. 先把审校任务和重译任务分开
给 AI 的指令里写清楚三件事,结果会稳定很多:
- 只对照、不重写:逐句比对原文和译文,发现问题就记一条,没有问题的句子原样跳过。
- 按表格输出:每条问题一行,列出 编号、原文句、译文句、问题类型、建议改法、依据(术语表第几行 / 禁译清单第几项 / 原文哪个词)。
- 不确定就标「待人工确认」:让它别为了凑结果硬改,问题类型拿不准时也写明。
一次喂多少内容,按你用的工具上下文长度来定。长文分段送审时,每段都带上同一份术语表和禁译清单,并在表格里写清段号,方便最后合并。提示词的角色和约束怎么写,可以参考 提示词里的角色与约束。
2. 术语表:一行一对,区分大小写,自己留版本
术语表格式可以直接照 Google Cloud Translation 的写法来整理,就算你最后用的是聊天类 AI,这套格式也好读、好比对。文档里有几条可以直接搬到审校流程里用:
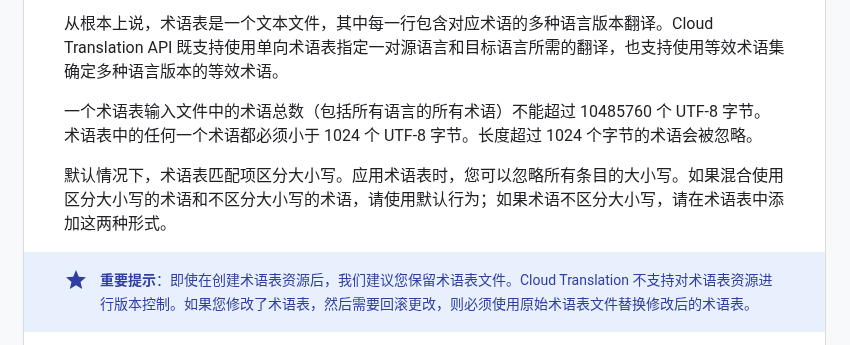
- 术语表本质是一个文本文件,每一行是同一术语的不同语言版本。只管一对语言时用单向术语表(TSV / CSV 每行两列:源语言、目标语言);多语言共用时用等效术语集(CSV 多列)。
- TSV / CSV 文件里不要加标题行,语言在创建术语表时另外指定。
- 默认区分大小写。如果某个术语不区分大小写,就把两种写法都加进去。
- 单个术语必须小于 1024 个 UTF-8 字节,超过的会被忽略;整份输入文件不超过 10485760 个 UTF-8 字节。
- 文档特别提示:Cloud Translation 不支持对术语表资源做版本控制,改错了要回滚,只能用原始文件替换。
落到审校流程里,你可以这样做:
- 术语表文件名带日期或版本号,例如
glossary-zh-v3-20261115.tsv,每次改动另存一份,不覆盖旧版。 - 送审时告诉 AI:原文里出现术语表第一列的词,译文必须用第二列的写法;没有用到的,记为「术语」类问题,并写出是第几行。
- 大小写不同的变体(例如产品名全大写和首字母大写)要分开列两行,否则 AI 和机器都可能判成不一致。
3. 禁译项:产品名、占位符和标签原样保留
禁译清单单独列一份,不要混在术语表里。常见的几类:
- 品牌名、产品名、功能名里规定保持英文的部分;
- 代码、命令、文件路径、URL;
- 变量占位符,例如
{name}、%s、{{count}}; - HTML 或 XML 标签及其属性。
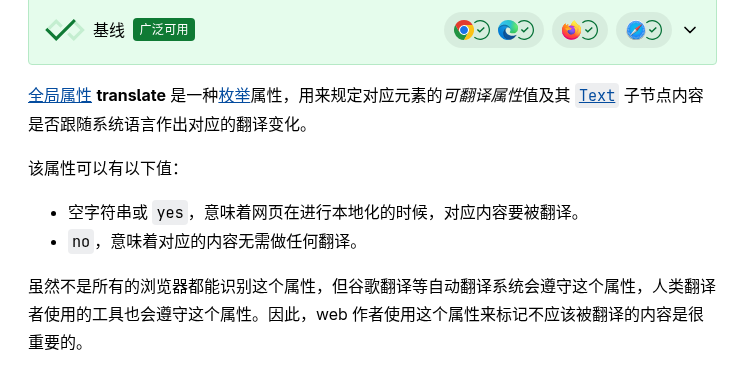
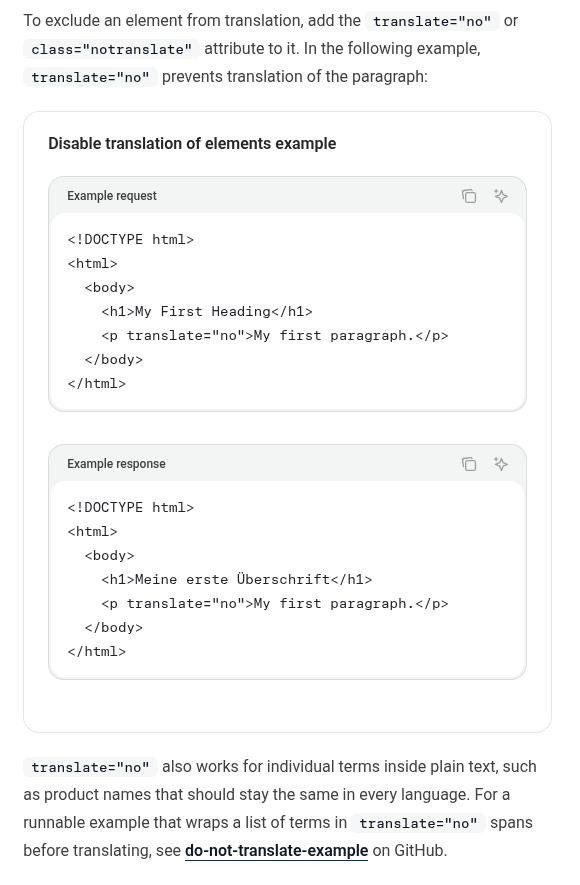
网页内容本身就可以用属性标出不翻译的部分。MDN 的说明是:全局属性 translate 取值为 no 时,对应内容不需要翻译;虽然不是所有浏览器都识别这个属性,谷歌翻译等自动翻译系统会遵守,人类译者用的工具也会遵守。
DeepL 的 HTML 翻译文档写法一致:要把某个元素排除在翻译之外,给它加 translate="no" 或 class="notranslate";translate="no" 也可以包在纯文本里的单个词上,比如每种语言都要保持不变的产品名。同一页还写明,不设置 tag_handling 时,标签会被当成普通文本处理,翻译 HTML 要把 tag_handling 设为 html。
审校时让 AI 对每一段做两项检查,结果写进表格:
- 禁译清单里的每一项,在译文里是否原样出现,没有被翻译、改大小写或加空格。
- 原文和译文里的占位符、标签数量是否相同,顺序是否合理。少一个
{name}或标签没闭合,上线后通常直接显示乱码或报错。
数字、日期、金额、单位也放进这一步核对,它们不算禁译项,但被「意译」后最难发现。
4. 对照验收:用 MQM 七类错误做问题分类
问题类型如果让 AI 自由发挥,会出现「表达不够自然」这种没法验收的描述。可以直接借用 MQM 错误分类的七个顶层维度:
| 维度 | 审校时看什么 |
|---|---|
| Terminology 术语 | 是否用了术语表规定的译法 |
| Accuracy 准确 | 有没有漏译、多译、误译 |
| Linguistic conventions 语言规范 | 语法、拼写、标点 |
| Style 风格 | 是否偏离你的风格指南 |
| Locale conventions 区域规范 | 日期、数字、货币等格式是否符合目标地区 |
| Audience appropriateness 受众适切 | 内容对目标地区读者是否不适用或不合适 |
| Design and markup 设计与标记 | 格式、标签、界面元素、版面 |
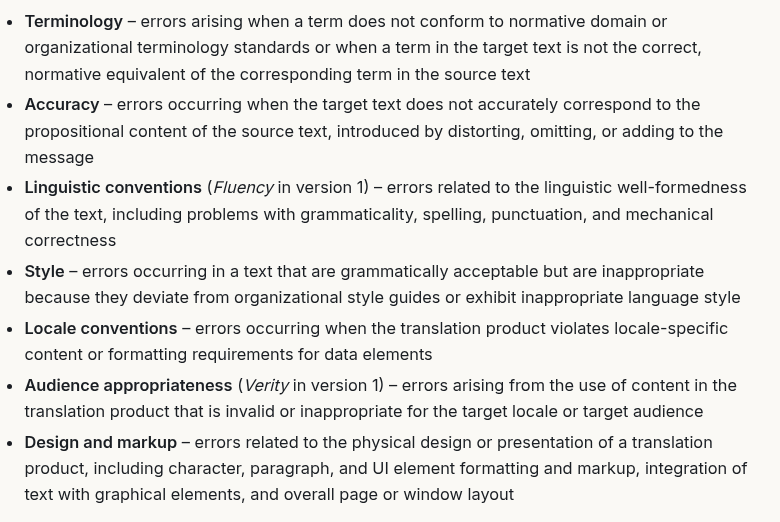
MQM 页面也写明,实施方可以按自己的环境选择分类粒度。个人或小团队用这七类就够了;第 3 步的禁译项和占位符问题,归到 Design and markup 或 Accuracy 里即可。
拿到 AI 输出的问题表后,人工按下面的顺序复核:
- 先看 Terminology 和 Design and markup 两类,它们最容易核对,对照术语表和禁译清单逐条确认。
- 再看 Accuracy,回到原文句子读一遍,确认 AI 说的漏译、误译是否成立。AI 自己也会看错,复核方法可参考 大模型幻觉怎么防。
- 每条问题标「接受 / 不接受 / 待定」,接受的才改进译稿。
- AI 判定「没有问题」的句子,自己抽一部分重新对照,抽检比例写进验收记录,下次按同样标准做。
5. 一段可以直接改的审校提示词
你是翻译审校员。下面给你:原文、译文、术语表(TSV,第一列原文,第二列固定译法)、禁译清单。
任务:逐句对照原文和译文,只报告问题,不要改写全文。
检查顺序:1)术语是否按术语表;2)禁译项是否原样保留,占位符和标签数量是否一致;3)漏译、多译、误译;4)数字、日期、单位;5)语法与风格。
输出:表格,列为 编号|段号|原文句|译文句|问题类型(Terminology/Accuracy/Linguistic conventions/Style/Locale conventions/Audience appropriateness/Design and markup)|建议改法|依据。
拿不准的写「待人工确认」,没有问题的句子不要列出。
送审前把原文和译文里的客户名、合同金额、内部链接等敏感信息先替换掉,哪些内容不该贴进对话框,见 AI 工具的数据隐私。译稿如果要在国内公开发布,AI 生成合成内容的标识要求见 AI 生成内容标识办法对自媒体意味着什么。
6. 可勾验收清单
- □ 术语表是一行一对(或多语言等效集)的文本文件,无标题行,文件名带版本号,旧版已保留
- □ 大小写不同的术语变体已分开列行
- □ 禁译清单单独成表,覆盖产品名、代码、URL、占位符、标签
- □ 网页类内容已用
translate="no"或class="notranslate"标出不翻译的部分;用 DeepL API 翻 HTML 时已设tag_handling=html - □ AI 只输出问题表,没有重写全文;每条问题都写了类型和依据
- □ 占位符、标签数量在原文和译文里一致;数字、日期、金额、单位已逐项核对
- □ AI 标出的问题已人工复核并标注接受与否;未报问题的句子已按记录的比例抽检
- □ 送审内容里的敏感信息已替换
相关阅读
- AI 翻译整份 PDF 文档:版式保留、术语表与人工校对流程
- 用 AI 读英文文档与论文:贴原文、对照摘要、抽术语的工作流
- 浏览器沉浸式翻译插件怎么用:安装来源、权限与常用设置
- 大模型幻觉怎么防:6 类高风险场景和一张核查清单
- 提示词里的角色与约束:少幻觉的六条写法模板
- AI 工具的数据隐私:哪些内容别往对话框里贴
来源(查询 2026-11-15,北京时间):Google Cloud 创建和使用术语表(高级版);DeepL Translating HTML;MDN translate 全局属性;MQM Council The MQM Error Typology。各工具的上下文长度、价格和界面文案未在本文写死,以你使用时的官方页面为准。