用 AI 写正则与 SQL:约束写法、样例驱动与结果验收清单(2026)
摘要:让大模型写正则或 SQL 时,最怕「看起来对、一跑就错」。本文给出约束型提示词写法、正负样例驱动,以及对照官方文档做结果验收的清单;覆盖 Python/JS 正则与 SQL LIKE/~ 等常见场景。只放官网普通链接;无联盟推广。
依据:MDN《正则表达式》、Python
re文档、PostgreSQL Pattern Matching、Microsoft Learn《LIKE (Transact-SQL)》、GitHub Docs《Prompt engineering for Copilot Chat》。查询日期:2026-10-16(北京时间)。工具可替换,不绑定某一家模型;只放官网/帮助中心普通链接(affiliate_later)。
本站已有 AI 生成 Excel 公式与数据清洗(电子表格公式)和 用 AI 辅助写代码:新手避坑。本文换一条线:正则表达式 + SQL 查询——两者都「看起来像自然语言、错了却很难肉眼看出来」。通用提示词框架见 提示词怎么写;交付前防幻觉见 大模型幻觉怎么防。
一、为什么正则/SQL 特别容易被 AI「写得像对」
| 坑 | 典型表现 | 后果 |
|---|---|---|
| 方言混用 | 把 PostgreSQL 的 ~ 写进 MySQL;把 JS /pattern/ 当 Python 字符串 | 直接语法错误或静默匹配失败 |
| 样例过少 | 只给 1 条「能匹配」的例子 | 漏掉边界:空串、全角数字、换行、重复匹配 |
| 贪心/非贪心 | .* 吃到行尾;SQL LIKE '%x%' 扫全表 | 性能事故或误伤半条日志 |
| 转义幻觉 | 编造 \d 在某引擎「一定支持」;或漏写 raw string | Python 字符串与正则双重转义翻车 |
| 语义偷换 | 「提取手机号」写成「任意 11 位数字」 | 校验通过、业务错误 |
敏感日志、身份证、未脱敏库表不要贴进公有模型,见 AI 工具的数据隐私。
二、约束写法:提示词里先钉死「引擎 + 输出格式」
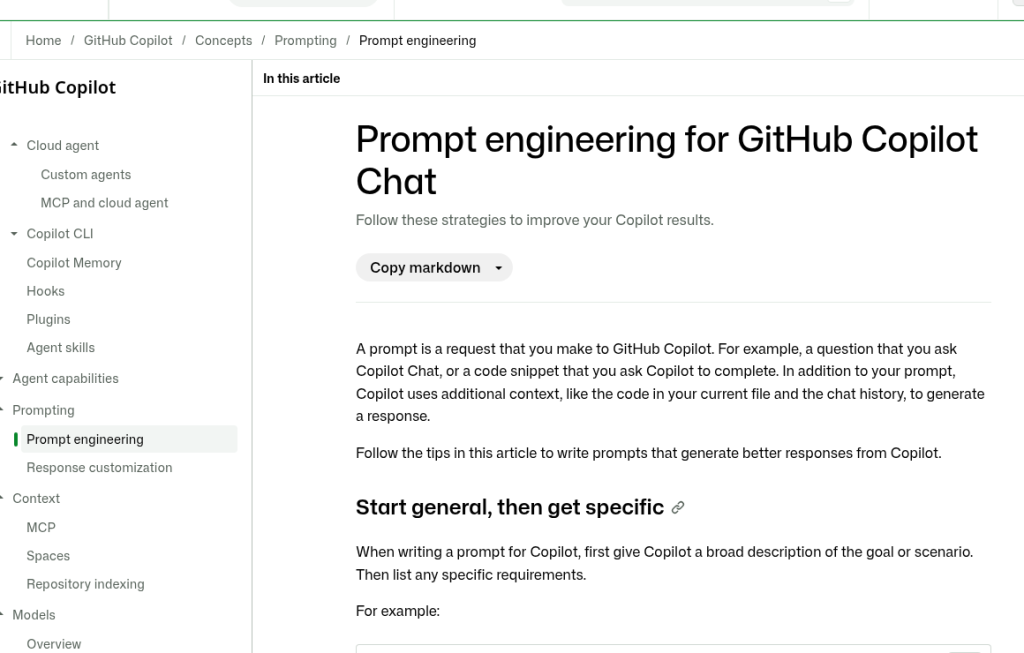
GitHub 官方提示工程建议:先概括目标,再列具体要求(Start general, then get specific)。落到正则/SQL,建议每次至少钉死这五项:
- 引擎/方言:Python
re/ JavaScript / PostgreSQL POSIX / T-SQLLIKE/ … - 任务一句:匹配、提取、替换、过滤行,还是写完整
SELECT。 - 输入形态:单行还是多行;字段名与类型;是否 UTF-8。
- 正负样例:≥3 条应匹配 + ≥2 条不应匹配(可用假数据)。
- 输出契约:只给表达式/SQL;禁止编造不存在的函数;附「我如何自测」三步。
正则约束模板(可直接改):
你是正则助手。引擎=【Python 3 re / JS / 其他】。
任务:【从文本提取/校验什么】。
硬性约束:
1) 只输出 1 个正则 + 3 行说明(捕获组含义、标志位、失败时行为);
2) 不要使用该引擎不支持的语法;拿不准就写「需查官方文档某某节」而不是猜;
3) 下面「应匹配」必须全中,「不应匹配」必须全不中;
4) 不要匹配我没要求的字段。
应匹配:
- ...
不应匹配:
- ...
SQL 约束模板:
你是 SQL 助手。方言=【PostgreSQL 16 / SQL Server / MySQL 8】。
表结构:【列名 类型,可假数据】。
任务:【过滤/聚合/窗口一句】。
硬性约束:
1) 只输出 1 条可执行 SQL;不要编造函数;
2) 模式匹配:优先说明用 LIKE 还是正则运算符(如 PG 的 ~ / ~*);
3) 给出用 5 行样例自测的预期结果表;
4) 不要 SELECT * 扫全库除非我明确要求。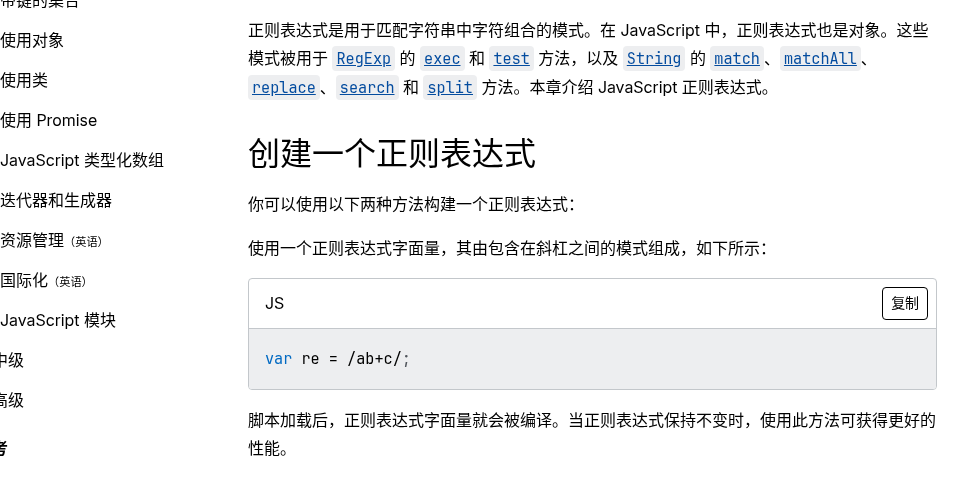
三、样例驱动:先写验收表,再让 AI 填表达式
不要先问「帮我写个邮箱正则」。先列一张迷你验收表(可放进提示词):
| # | 输入样例 | 期望 |
|---|---|---|
| 1 | user@example.com | 匹配 / 提取 domain=example.com |
| 2 | user@example | 不匹配 |
| 3 | 用户@例子.公司 | 【按你业务决定:拒或收】并写清 |
让 AI 对着表交答案;你再用引擎跑一遍。MDN 写明可用 test/match 等方法验证;Python 文档强调 raw string(r"...")避免反斜杠被字符串层吃掉。
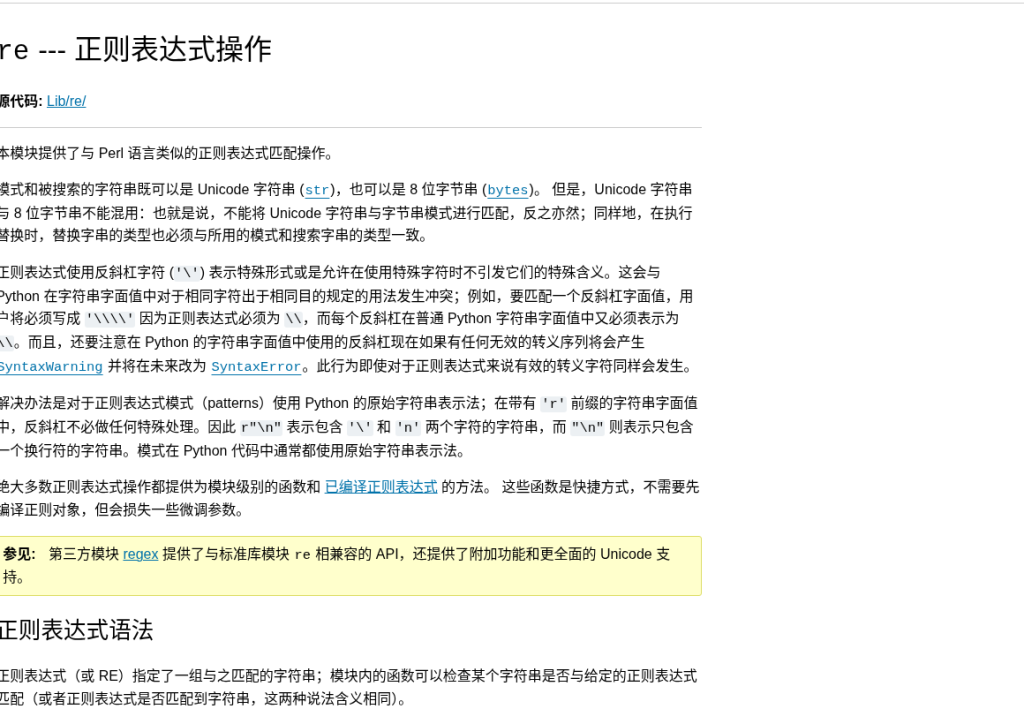
re:模式与字符串类型须一致;推荐 raw string 处理反斜杠(官方文档截图)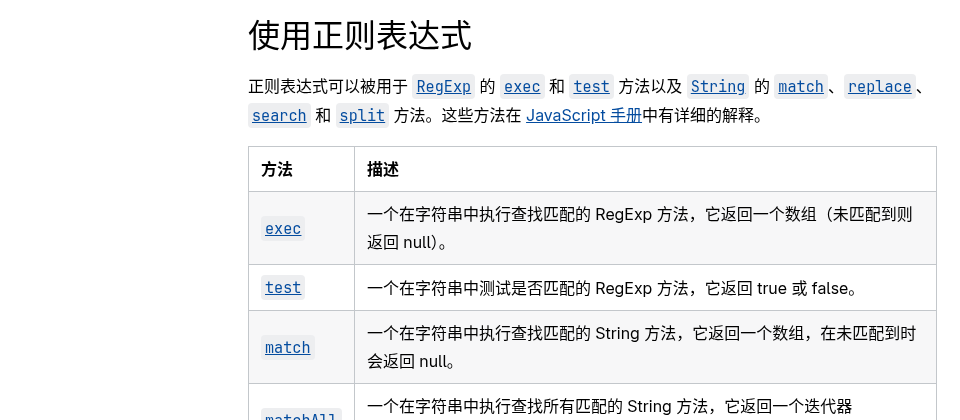
SQL 侧先分清两层:
- 通配符:T-SQL / 多数方言的
LIKE(%_),见 Microsoft Learn 语法页。 - 正则:例如 PostgreSQL 的
~/~*/!~/!~*(POSIX),与LIKE不是同一套语法。
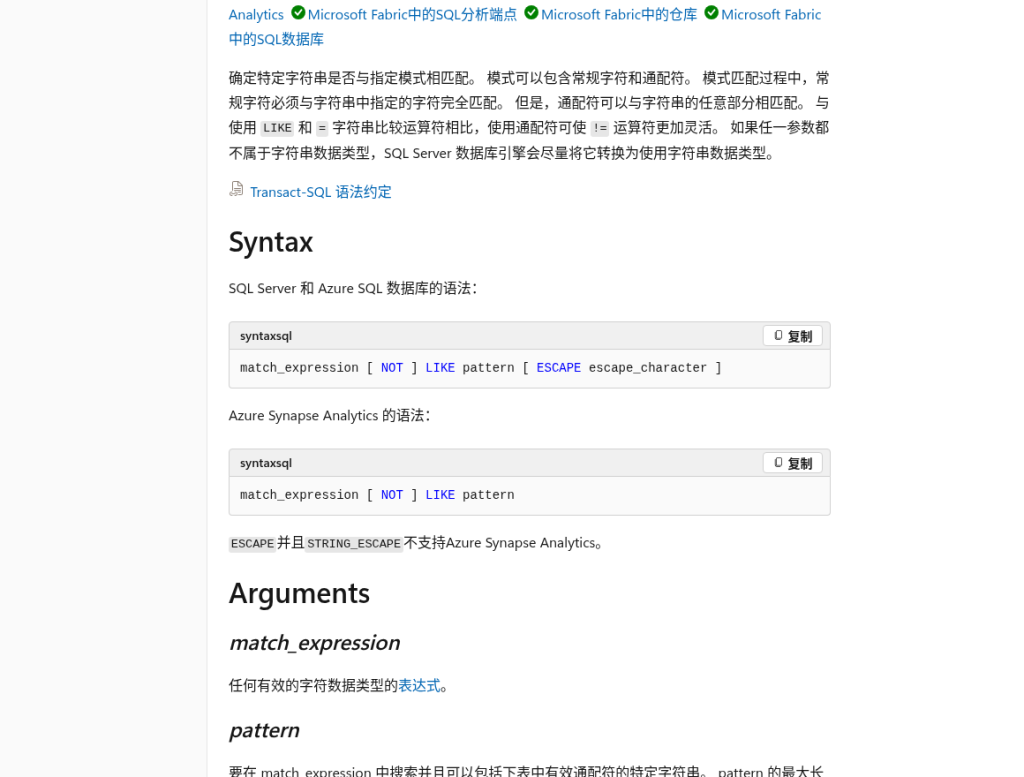
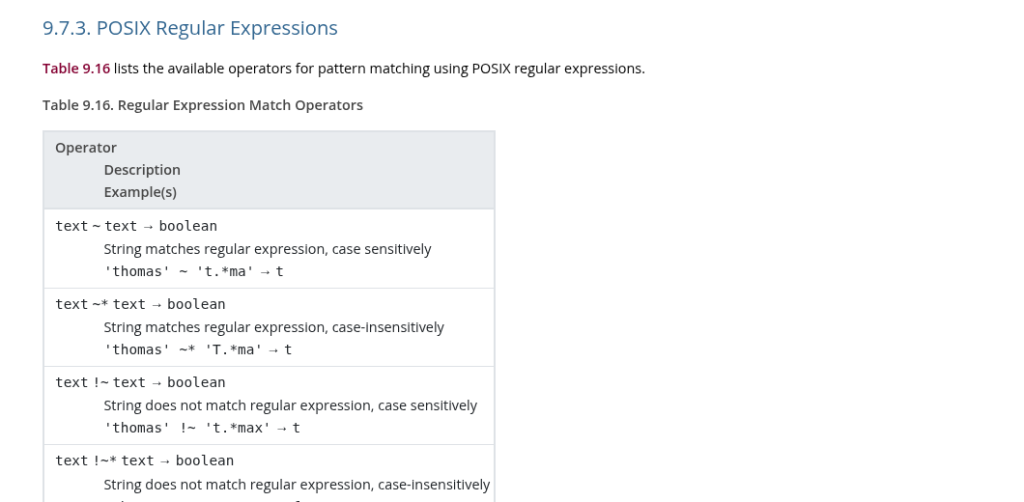
AI 若把 LIKE '%\d+%' 和 ~ '\d+' 混在同一方言里,就是红灯——对照上表打回重写。
四、结果验收清单(上线前勾)
- □ 方言一致:表达式能在目标引擎直接跑,无「邻居方言」函数。
- □ 正负样例全过:应匹配全中、不应匹配全不中;补测空串、超长、Unicode。
- □ 捕获组/列名:提取任务核对组号或别名;SQL 核对数与类型。
- □ 性能粗看:前导
%的LIKE、无锚点的.*是否会扫爆;大数据先LIMIT试跑。 - □ 对照官方页:元字符、标志位、
LIKE与正则运算符以本文链接的文档为准,不凭模型记忆。 - □ 无敏感数据进提示词:用假样例;真数据只在本地跑测。
- □ 人工抽查边界:换行、全角数字、重复匹配、大小写(
~*vs~)。
和表格场景一样,复杂逻辑可先在 WPS AI 表格分析 或本地脚本里用小样验证,再铺到全量。编程工具选型见 Cursor / Copilot / 通义灵码怎么选。
五、相关阅读
来源(查询 2026-10-16):MDN 正则指南;Python re;PostgreSQL Pattern Matching;Microsoft Learn LIKE;GitHub Copilot prompt engineering。