云服务器进程突然被杀:OOM 日志、swap 和内存占用怎么核对(2026)
摘要:网站半夜 502、MySQL 自己停了、Docker 容器反复重启,查下来常常是内存不够,内核的 OOM Killer 挑了一个进程杀掉。本文按阿里云、腾讯云官方文档整理:先用 dmesg、journalctl 确认有没有 OOM,再分清是整机内存不足还是 cgroup(容器)限额打满,接着用 free、ps 找占内存的进程,最后决定加 swap、限内存还是升配。查询日期 2026-11-22。
依据:腾讯云文档《TencentOS Server OOM Killer 分析与处理》(2026-08-24 更新)、阿里云帮助中心《如何处理 Linux 实例中的 OOM 问题?》、《Alibaba Cloud Linux 出现 OOM Killer 的原因及解决方案》,以及 Docker 官方文档《Resource constraints》。查询日期:2026-11-22(北京时间)。命令以 Ubuntu、Debian、CentOS 系常见环境为例,不同发行版的日志位置略有差别。
你的网站早上打开是 502,登录服务器一看,MySQL 或 PHP-FPM 进程没了,systemctl status 显示它被 kill;或者 Docker 里的容器隔一阵就重启一次。磁盘没满、带宽也正常,这种情况先查内存。Linux 内存耗尽、回收不回来的时候,内核会启动 OOM Killer(Out-Of-Memory Killer),挑一个进程直接杀掉,给系统腾内存。
本站写过云服务器报 No space left:df、inode 与日志/容器占用怎么核对,那篇查的是磁盘;这篇查内存,顺序是:确认有没有 OOM → 分清整机还是容器 → 找占内存的进程 → 决定怎么处理。
1. 先确认到底有没有发生 OOM
腾讯云文档把查内核日志列为首选方法,给了三种命令:
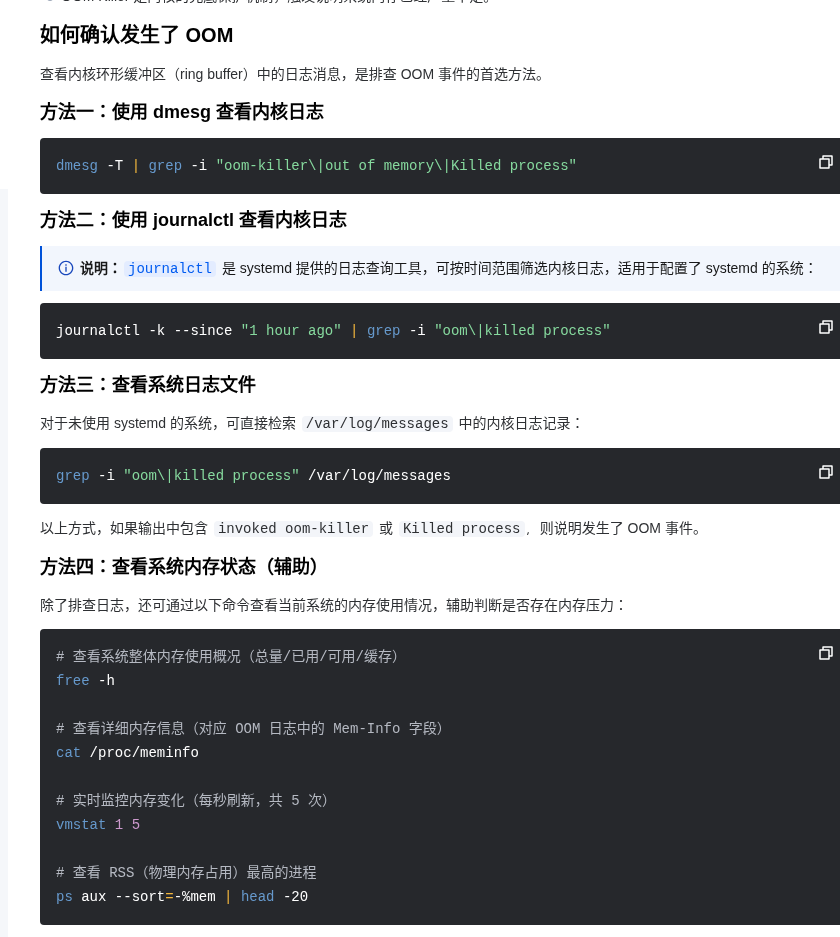
# 方法一:内核环形缓冲区(重启后会清空)
dmesg -T | grep -i "oom-killer\|out of memory\|Killed process"

# 方法二:systemd 系统按时间查内核日志
journalctl -k --since "1 hour ago" | grep -i "oom\|killed process"

# 方法三:没有 systemd 的系统查日志文件(Ubuntu/Debian 多为 /var/log/syslog)
grep -i "oom\|killed process" /var/log/messages
输出里出现 invoked oom-killer 或 Killed process,就说明发生过 OOM。核对时注意两点:
dmesg重启后就没了。如果服务器已经重启过,用journalctl -k -b -1(上一次启动的内核日志,需要开启持久化日志)或日志文件去查。- 触发的进程和被杀的进程常常不是同一个。腾讯云文档原话是「调用 OOM Killer 的进程 ≠ 被杀的进程」:
xxx invoked oom-killer里的 xxx 只是恰好申请内存失败的那个,真正被杀的看Killed process 1234 (mysqld)这一行,内核挑的是 oom_score 最高的进程。
阿里云文档给的思路一样:在 /var/log/messages 或 /var/log/syslog 里用 oom、kill 做关键字搜索,业务应用自己也有日志的,再到应用日志里对时间点。
2. 分清是整机内存不够,还是容器、cgroup 限额打满
同样是 OOM,原因可能完全不同。阿里云 Alibaba Cloud Linux 文档把内存不足分成实例全局内存不足和cgroup 内存不足两大类,日志里的关键字不一样:
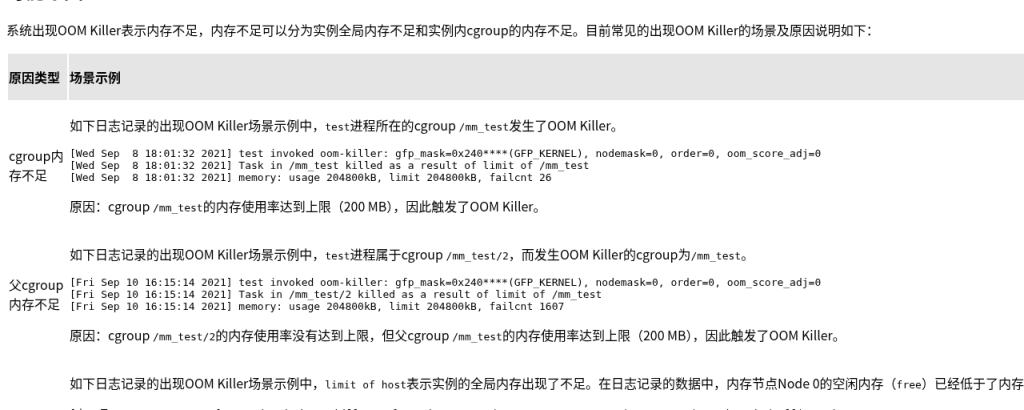
- 日志写
limit of host:整台机器的内存不够,空闲内存低于内核的最低水位线,回收不回来。 - 日志写
limit of /某个路径,旁边有memory: usage ... limit ...:是某个 cgroup 的内存上限打满了,整机可能还有大量空闲内存。Docker 容器、systemd 服务设了MemoryMax的,都属于这一类。 - 父 cgroup 打满:进程所在的 cgroup 没到上限,但上一级 cgroup 到了,也会触发。
用 Docker 跑网站的,按容器单独核对一遍:
# 容器最近一次退出是不是因为 OOM(true 表示被 OOM 杀掉)
docker inspect --format '{{.State.OOMKilled}} {{.State.ExitCode}}' 容器名

# 看各容器当前内存占用和上限
docker stats --no-stream
退出码 137 表示进程收到了 SIGKILL,OOM 是最常见的原因之一,但手动 kill -9 也是 137,要和 OOMKilled 一起看。Docker 官方文档提醒,Docker 会调低守护进程自己被 OOM 杀掉的优先级,容器的优先级不调,所以内存紧张时容器比 Docker 本身更容易被杀;文档同时建议给容器设内存上限,并且不要用 --oom-kill-disable 或把 --oom-score-adj 调到极低去硬扛。用 compose 部署 WordPress 的,可以对照本站的用 Docker 部署 WordPress:compose 文件、数据卷备份与升级检查各服务的内存设置。
3. 找出是谁在吃内存
确认是整机内存不足后,看当前占用:
free -h                         # 看 available 这一列,不要只看 free
ps aux --sort=-%mem | head -20  # 按内存占用排序,RSS 列是实际物理内存
vmstat 1 5                      # 每秒刷新一次,si/so 持续不为 0 说明在频繁换页
free 列的数字小不代表内存不够,Linux 会把空闲内存拿去做文件缓存,available 才是还能分给程序的量。腾讯云文档把常见原因整理成了一张表,按日志和现象对号入座:
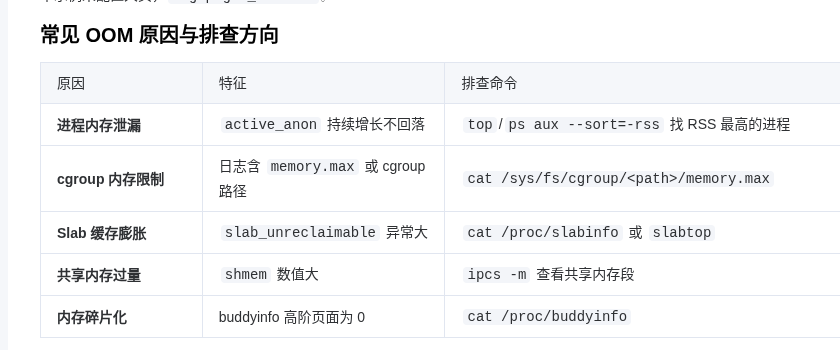
小内存云服务器上建站,最常见的是这几种:
- MySQL / MariaDB 缓冲池设得比机器内存还大。1G、2G 内存的机器直接用默认或网上抄来的大配置,
innodb_buffer_pool_size一个参数就能吃掉大半内存。 - PHP-FPM 子进程太多。
pm.max_children设得高,访问量一上来每个子进程几十 MB,一起把内存撑满。 - 定时任务、备份脚本扎堆。压缩备份、
mysqldump、图片处理在同一时间跑,内存峰值叠在一起。 - 程序内存泄漏。某个进程的 RSS 一天比一天高、从不回落,重启才降下来。
找到元凶以后,先从配置上收:调小数据库缓冲池、降低 PHP-FPM 子进程上限、把重任务错开时间。这几步不花钱,小站很多时候调完就够用。
4. 加 swap:给突发峰值留缓冲
很多云服务器镜像默认没有 swap。腾讯云文档的说法是:适当配置 swap 可以在物理内存不足时提供缓冲,不推荐对性能敏感的场景用大 swap。
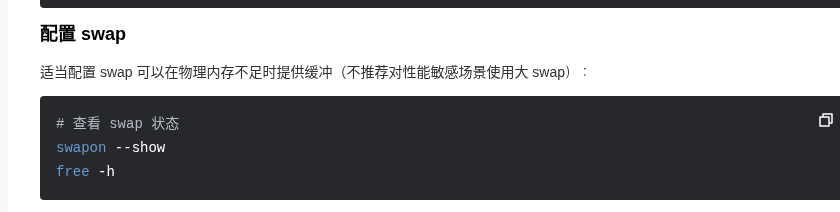
先看有没有:
swapon --show
free -h
没有的话,用 swap 文件加一块(下面以 1G 为例,按需调整):
sudo fallocate -l 1G /swapfile   # 个别文件系统不支持时改用 dd 创建
sudo chmod 600 /swapfile
sudo mkswap /swapfile
sudo swapon /swapfile
echo '/swapfile none swap sw 0 0' | sudo tee -a /etc/fstab   # 开机自动挂载
加之前核对三件事:
- 磁盘余量够不够。swap 文件占的是系统盘空间,系统盘本来就紧的先清盘。
- swap 只是缓冲。它比内存慢得多,
vmstat里 si/so 长期很高,说明机器一直在换页,网站会变慢,这时该减负或升配。 - 写进
/etc/fstab前确认路径没写错,写错可能导致开机挂载失败。改之前先给云服务器做个快照,方法见本站的云服务器快照与自定义镜像:定时策略、保留份数与一键恢复演练。
5. 保护关键进程、限制大户
腾讯云文档给了两种调优方式:
- 调低关键进程被杀的概率:在 systemd 服务的
[Service]段写OOMScoreAdjust=-100之类的负值,数值越低越不容易被选中,-1000 等于完全禁止 OOM 杀它。别把所有进程都设成 -1000,内存真耗尽时内核没得可杀,后果更难收拾。 - 用 cgroup 限制某个程序的内存上限:让吃内存的大户撞自己的上限,别拖垮整机。systemd 服务可以写
MemoryMax=,Docker 容器用--memory或 compose 里的内存限制。
6. 优化完还是不够,就升配
阿里云文档的处理建议分两条:配置太低就升级实例内存,程序用内存不当就优化代码,比如批量查询改成分页。
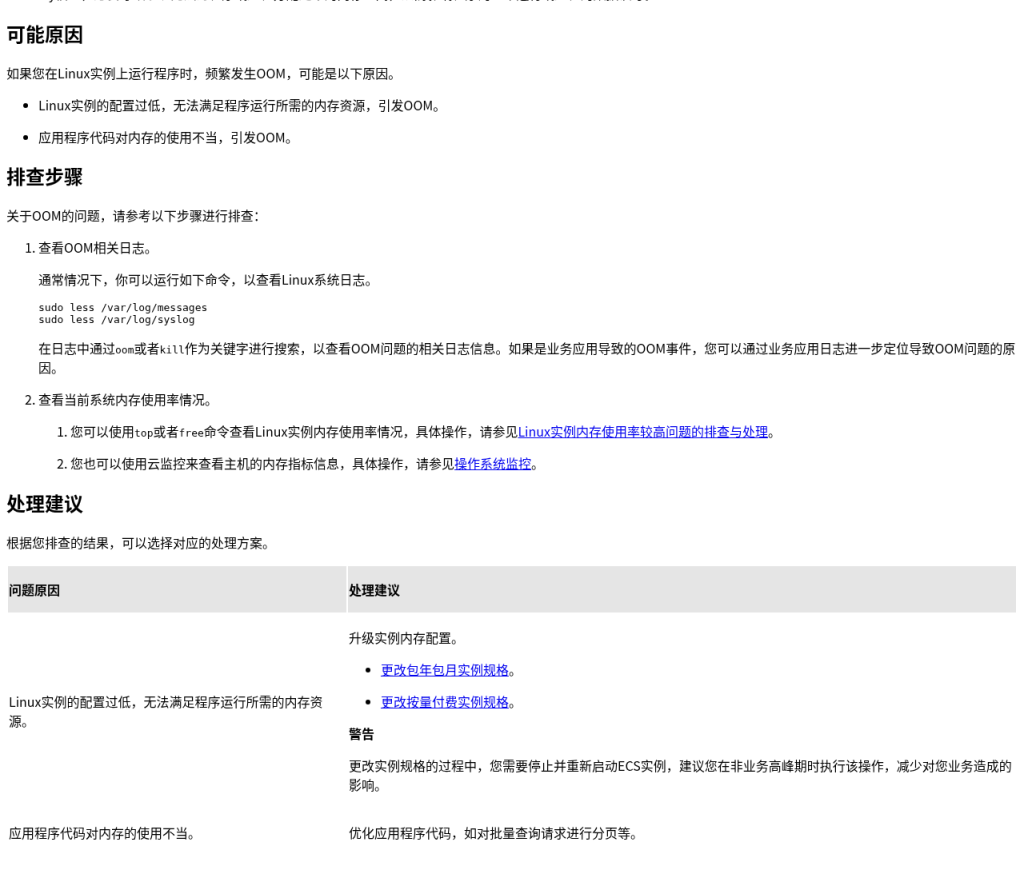
升配前核对:
- ECS 更改规格要停机重启,阿里云文档提醒放在业务低峰期操作;腾讯云文档也写明升级规格通常需要重启,部分实例类型支持在线变配,以产品文档为准。
- 轻量应用服务器的升级规则和 ECS 不同,本站的轻量应用服务器升降配:只升不降、套餐整体升级与数据盘扩容注意写了细节。
- 先排除内存泄漏。腾讯云文档原话是避免仅通过扩容掩盖问题,泄漏的进程换了大内存,过几天照样会被杀。
7. 设好告警,下次早点发现
腾讯云文档建议对三项指标设告警:可用内存低于总内存 10%、oom-killer 事件次数大于 0、进程 RSS 接近系统内存总量。云厂商控制台的云监控能设内存使用率告警;也可以在服务器上定期跑一次:
dmesg -T | grep -c "oom-killer"网站层面再加一个外部可用性监控,网站一挂就收到通知,可以对照本站的网站可用性监控设置:HTTP 探测、证书到期与告警渠道。
8. 排查清单
dmesg -T、journalctl -k或日志文件里搜到Killed process,记下被杀进程名和时间。- 看日志是
limit of host(整机)还是limit of /路径(cgroup、容器)。 - 容器用
docker inspect看OOMKilled,退出码 137 要结合着看。 free -h看 available,ps aux --sort=-%mem找占用最高的进程。- 先调配置:数据库缓冲池、PHP-FPM 子进程数、定时任务错峰。
- 没有 swap 的小内存机器加一块 swap 文件,改
/etc/fstab前做快照。 - 关键服务适当调
OOMScoreAdjust,大户用MemoryMax或容器内存上限。 - 排除泄漏以后仍不够,再升配,选低峰期操作。
- 设内存使用率和 OOM 次数告警。
说明
本文只整理阿里云、腾讯云和 Docker 官方文档里写明的方法,命令输出和参数名以你服务器上的实际版本为准。改内核参数、systemd 配置和 /etc/fstab 前先做快照。文中只放官网普通链接,无推广链接。
相关阅读
- 云服务器报 No space left:df、inode 与日志/容器占用怎么核对
- 云服务器带宽跑满:进程、CDN 与安全组限流怎么查看
- 轻量应用服务器升降配:只升不降、套餐整体升级与数据盘扩容注意
- 用 Docker 部署 WordPress:compose 文件、数据卷备份与升级
- Uptime Kuma 自建监控:HTTP/SSL 探测与告警渠道怎么配
官方来源与查询日期
- 腾讯云文档:TencentOS Server OOM Killer 分析与处理(2026-08-24 更新)
- 阿里云帮助中心:如何处理 Linux 实例中的 OOM 问题?
- 阿里云帮助中心:Alibaba Cloud Linux 出现 OOM Killer 的原因及解决方案
- Docker 文档:Resource constraints
- 查询日期:2026-11-22(北京时间)